论文总结 · 2026/07/18
看过的论文合集
看过的论文合集
推理范式
Thinking with Images for Multimodal Reasoning: Foundations, Methods, and Future Frontiers
https://arxiv.org/abs/2506.23918
传统多模态 Chain-of-Thought 往往仍以语言作为唯一推理介质:图像只在推理开始时被编码一次,后续步骤主要在文本符号空间内展开。论文提出“Thinking with Images”范式,把视觉从静态输入提升为可被生成、修改、重组和反复查询的中间工作空间,并将相关方法归纳为外部视觉工具、程序化视觉操作和内生视觉想象三个阶段。
VLA
Discrete Tokens VLA
OpenVLA: An Open-Source Vision-Language-Action Model
https://arxiv.org/pdf/2406.09246
https://www.songbozhang.top/article/openvla
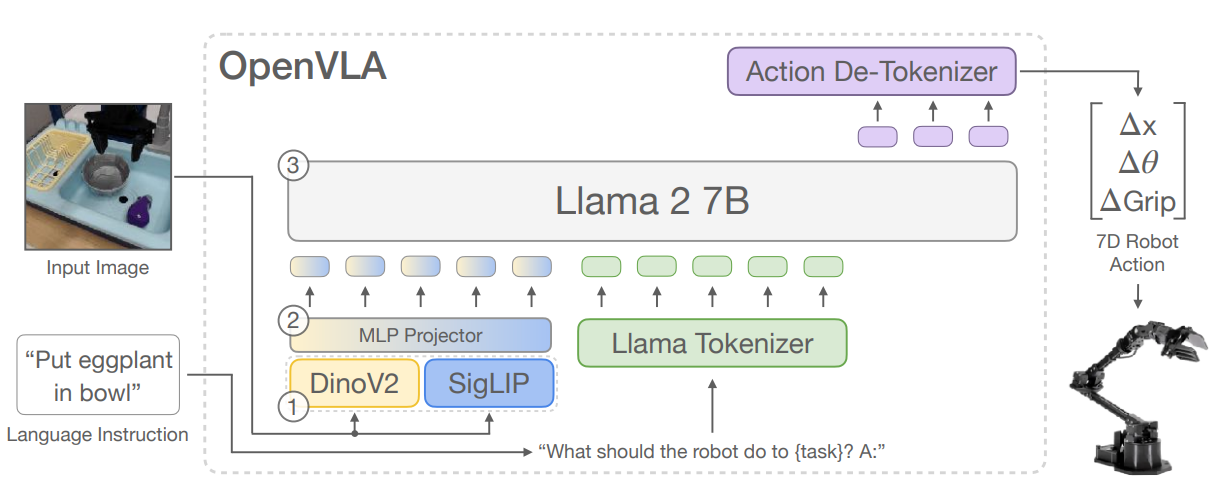 将 DINOv2 的空间局部特征与 SigLIP 的语义特征融合到 Llama 2 语言模型中,并把七维机器人动作逐维量化为离散 token,使动作预测能够直接复用标准的自回归 next-token 训练框架。模型以约 97 万条真实机器人轨迹训练,证明了开放权重的 7B 模型也能获得较强的跨任务、跨物体和语言条件泛化能力。
OpenVLA 的动作表示非常直接:平移、旋转和夹爪状态分别被离散到 256 个区间,再替换语言模型词表中的低频 token。该设计降低了开发门槛,也使 LoRA 微调、量化部署和常规语言模型训练工具能够直接用于机器人策略。
局限性在:逐维、逐时刻的离散自回归输出会带来量化误差和推理延迟;单帧视觉输入缺乏显式历史,较难处理速度、遮挡和任务阶段;控制频率降低还会造成训练动力学与部署动力学不一致。
后续论文几乎逐项回应了这些限制:FAST 压缩高频动作序列, 用 flow matching 直接生成连续动作块,MolmoAct在动作前加入深度和二维轨迹, 加入高层子任务预测,LingBot-VLA则通过更大规模真实数据和高吞吐训练框架强化适配能力。OpenVLA仍是重要参照,因为它清楚展示了“把动作当语言 token”路线的工程优雅性,以及这种统一方式在连续控制上的上限。
MolmoAct Action Reasoning Models that can Reason in Space
https://arxiv.org/abs/2508.07917
https://www.songbozhang.top/article/molmoact
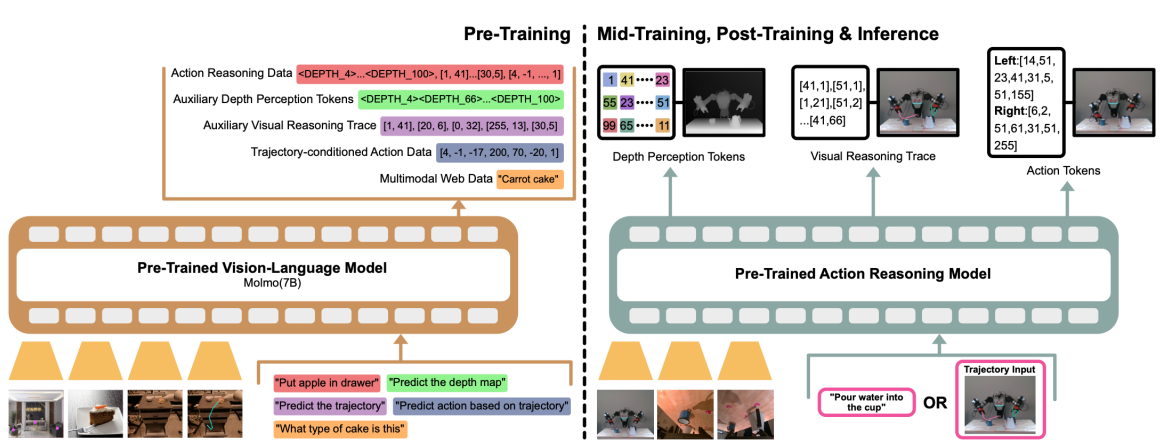 MolmoAct提出 Action Reasoning Model,不再直接从图像和指令跳到动作,而是依次生成深度感知 token、可编辑的二维末端轨迹和低层动作 token。它把机器人“思考”从不可见的隐状态转变为可解码、可视化、可人工干预的空间变量,核心逻辑可以概括为“理解空间—画出运动路线—执行控制”。
深度监督来自 Depth Anything V2 的伪标签,并经 VQ-VAE 压缩为离散 token;轨迹监督由未来若干帧中的夹爪二维位置构成;最终动作仍采用自回归离散 token。论文还使用具有单调邻接关系的连续 BPE token 初始化动作编号,以减少完全随机的动作嵌入初始化问题。
其优势是可解释和可控:用户可以检查深度、修改轨迹,或明确定位错误发生在感知、规划还是执行阶段。局限同样来自这些中间监督:伪深度和自动夹爪定位的误差会进入训练;二维折线不能完整表达三维绕障、接触姿态和力;三阶段自回归生成还会增加延迟。换言之,它显著改善了“为什么这样动”的透明度,但并未完全解决高频连续控制和真实三维动力学建模。
MolmoAct是“Thinking with Images”在 VLA 中最直接的实例之一,也与 Gemini Robotics-ER 的空间轨迹推理形成呼应。与的纯连续动作专家相比,它更强调可解释的中间过程;与的语言子任务相比,它选择了更接近控制的空间轨迹;与 DreamVLA 相比,MolmoAct在推理时显式输出中间表示,而 DreamVLA主要把未来知识作为训练期辅助监督。两条路线分别代表“可见的空间推理”和“隐式但紧凑的世界知识”。
Diffusion Policy VLA
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
https://arxiv.org/abs/2303.04137 https://www.songbozhang.top/article/diffusion-policy
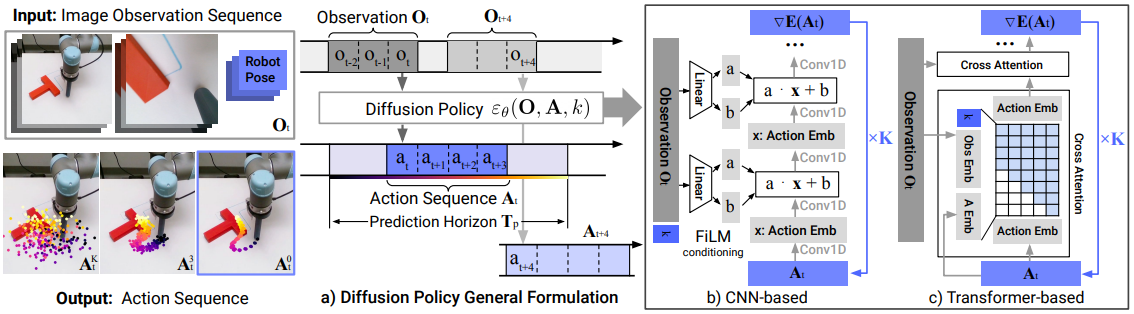
Diffusion Policy把机器人动作策略建模为条件扩散过程:策略不是为当前观测回归一个唯一动作,而是从噪声中逐步生成一段未来动作序列。该方法特别适合存在多种合理操作轨迹的任务,避免均方误差回归把多种解平均成不可执行的“中间动作”。
模型以视觉观测为条件,对整段动作进行加噪和去噪训练,并结合 receding-horizon control:每次生成动作块,只执行前一部分,随后重新观测并重规划。论文分别探索卷积和 Transformer 去噪器,在多种机器人操作基准上取得稳定提升。动作块联合生成带来了更好的时间一致性,而随机采样允许策略表达多峰动作分布。
优势在于连续动作精度、训练稳定性和对多模态分布的表达能力,它为灵巧操作建立了强大的通用模仿学习基线。主要代价是多步去噪带来的在线延迟;模型本身不包含互联网级语言知识、任务分解或跨机器人统一表示,通常仍依赖目标任务的高质量演示。它解决的是“怎样生成好动作”,而不是“怎样理解开放世界任务”。
继承了扩散式动作生成的基本思想,但采用 flow matching 和 VLM 主干,将语义预训练、跨机器人数据与连续动作块结合;DreamVLA继续使用扩散动作头,却在其前面加入未来世界知识;Cosmos Policy、DreamZero和MotuBrain则把扩散从纯动作空间扩展到视频—动作联合空间。因此,Diffusion Policy既是VLA连续控制路线的起点,也是后来WAM将生成建模引入机器人策略的技术祖先
: A Vision-Language-Action Flow Model for General Robot Control
https://www.pi.website/download/pi0.pdf https://www.songbozhang.top/article/pi0
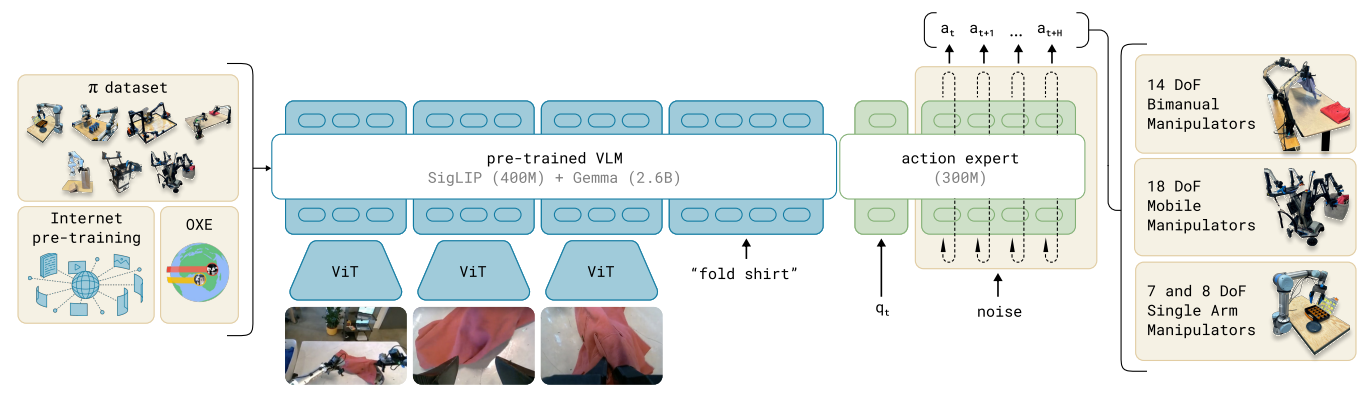 在预训练视觉语言模型旁增加独立的 action expert,以 flow matching 生成连续动作块,从而同时继承互联网语义知识和高频、灵巧控制能力。模型在多种机器人形态和任务上联合训练,展示了一个通用策略既可通过提示直接执行任务,也可用少量高质量数据后训练为专用策略。
VLM主干处理图像和语言,action expert处理机器人状态、带噪动作与连续输出,两者通过注意力交互。模型一次联合生成约50步动作,并通过若干Euler积分步骤把随机噪声运输到条件动作分布;实际部署中采用滚动动作块和KV缓存,支持最高约50 Hz的底层执行。相较OpenVLA的离散逐维生成,这种设计保留了动作精度和时间连贯性。
它的核心优势是把VLM语义能力、连续生成模型和跨具身数据放入一个可扩展框架,尤其适合折衣、装箱等存在多种正确轨迹的任务。局限是训练仍高度依赖大规模遥操作数据和昂贵算力;动作块内部有一段开环执行,遇到快速扰动时可能反应不足;模型没有稳定的长期记忆、任务完成判定或显式高层计划。它证明了通用灵巧控制可行,但尚未解决开放家庭中的长时序自主性。
直接解决了OpenVLA离散化和高频控制的不足,并成为、和的动作基础。补上异构数据和子任务层级,补上从部署经验中学习,再用丰富上下文区分优质、次优和不同策略的数据。LingBot-VLA采用相近的理解专家—动作专家与flow matching结构,说明这套架构已经成为通用VLA的重要主流方案。
: a Vision-Language-Action Model with Open-World Generalization https://arxiv.org/abs/2504.16054 https://www.songbozhang.top/article/pi05
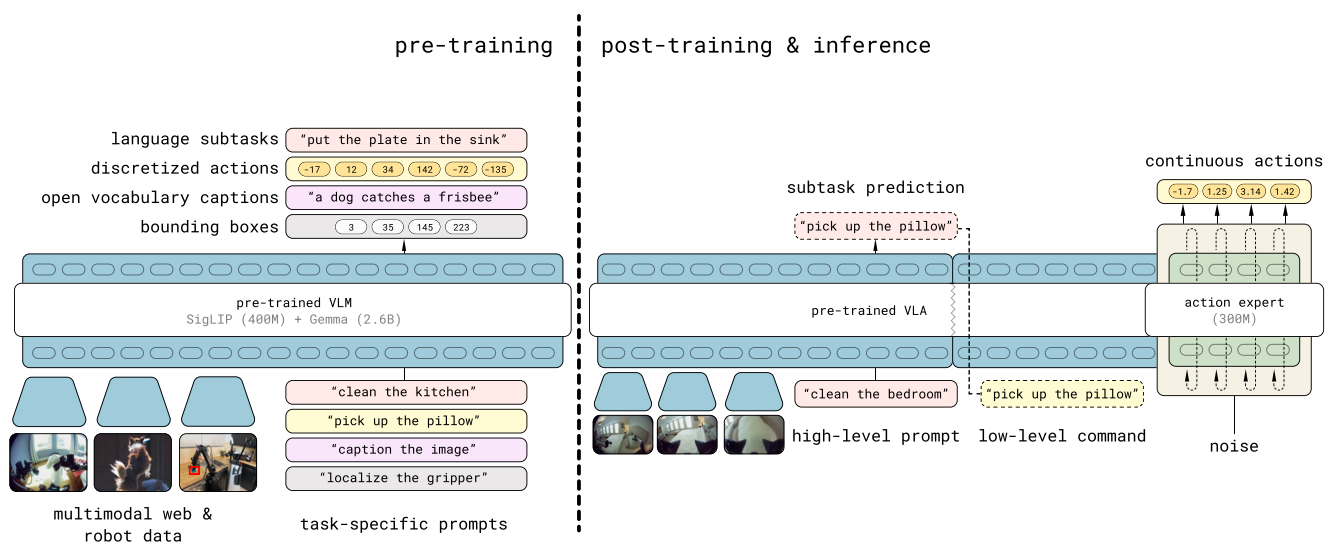
把从通用操作策略推进为面向开放世界、长程家庭任务的层级VLA。模型在生成低层连续动作前先预测当前应该完成的语言子任务,并通过目标机器人数据、其他机器人数据、高层标注、Web多模态数据和FAST动作token进行异构协同训练
训练先进行统一的离散next-token预训练,覆盖文本、子任务、检测框、Web任务和FAST动作token;随后加入式flow-matching action expert,联合优化语义token损失和连续动作损失。实验展示了机器人在未参与训练的新住宅中执行清洁厨房、整理卧室等10至15分钟的多阶段任务,说明高层监督和多环境、多具身数据能够显著改善开放世界泛化
高层策略学习到的是与机器人真实能力匹配的子任务,而不是由外部通用LLM凭空规划。局限是长程任务仍缺少可靠记忆、完成状态和循环检测;遇到全新物理结构、复杂偏好或不确定情况时,模型缺乏主动求助机制。
同时吸收了的连续动作、FAST的离散压缩和类似embodied CoT的层级规划。它与Gemini Robotics的高层推理—低层动作分层思路相近,但训练耦合更紧;与MolmoAct相比,它用语言子任务而非二维轨迹作为中间变量。随后进一步加入视觉子目标、质量、速度和错误元数据,使层级提示不仅描述“下一步做什么”,还描述“应该以何种策略和质量完成”。
FAST:Efficient Action Tokenization for Vision-Language-Action Models
https://arxiv.org/abs/2501.09747 https://www.songbozhang.top/article/fast
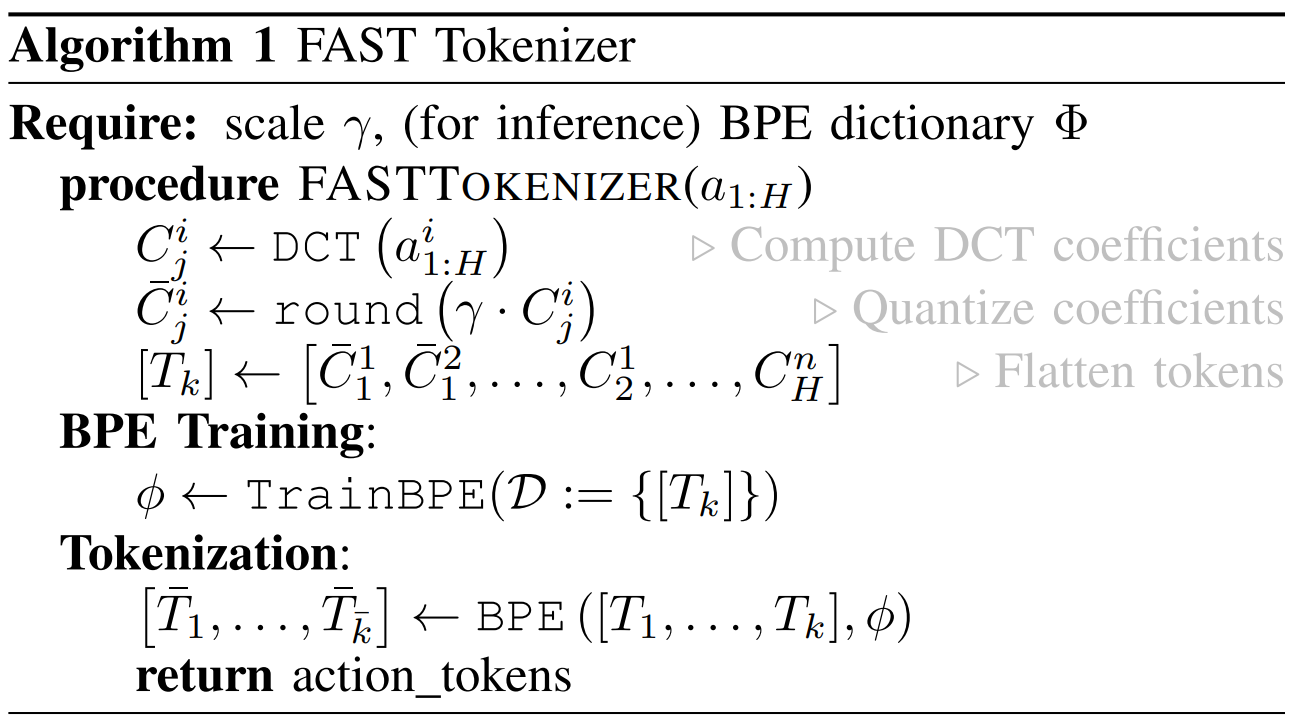
FAST针对自回归VLA中高频动作token过长、重复严重的问题,提出频域动作序列tokenization。它先沿时间轴对动作块做离散余弦变换,将平滑动作的大部分信息集中到少量低频系数,再量化并用BPE压缩常见模式,从而以更短token序列表达完整连续轨迹。
具体流程包括分位数归一化、逐动作维度DCT、频率系数量化、低频优先展开和BPE合并。FAST+进一步在约一百万条机器人轨迹上训练通用动作tokenizer,可跨动作空间和控制频率使用。论文报告动作token数减少约2至13倍,在高频双臂和灵巧任务中显著优于逐点离散化,并可用最多约5倍更少的训练计算达到接近扩散VLA的性能。
FAST保留了自回归模型与语言token统一训练的优势,同时把时间冗余显式压缩,是离散VLA路线中非常实用的工程改进。局限是DCT和量化本质上有损,高频突变、接触瞬间或不平滑动作可能被弱化;BPE词表对训练数据分布敏感;即使token更短,自回归解码仍可能慢于并行生成的flow或diffusion动作专家。
: a VLA That Learns From Experience
https://arxiv.org/pdf/2511.14759 https://www.songbozhang.top/article/dollarpi06dollar
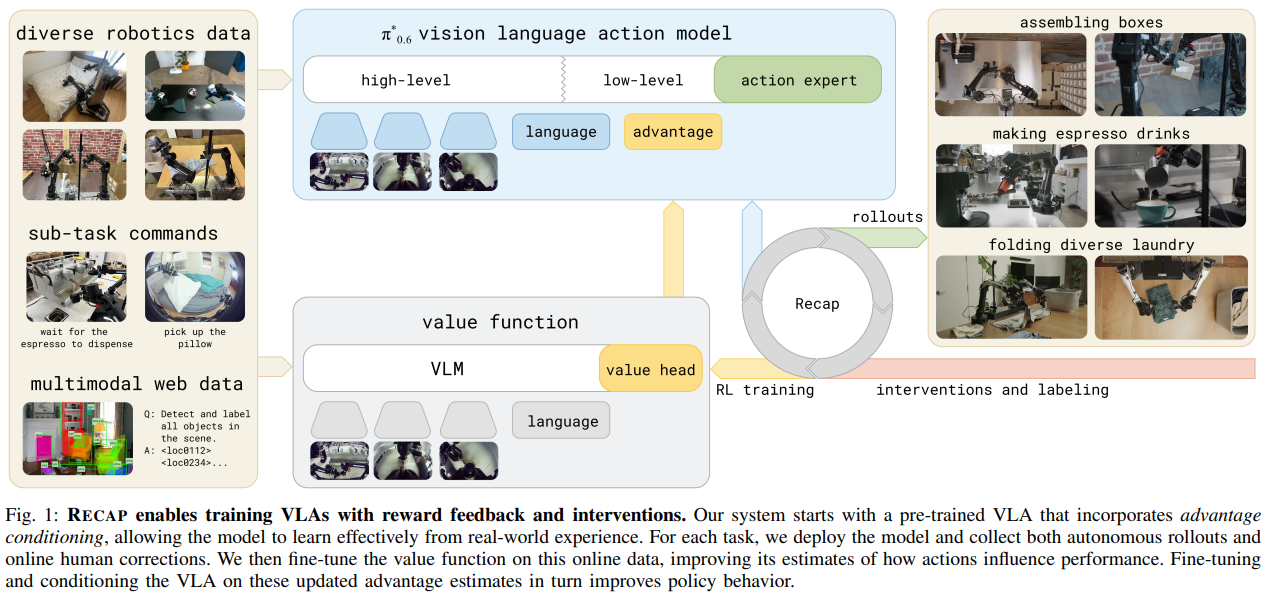 与RECAP方法解决的是模仿学习策略“基本会做但不够可靠”的问题。系统把真实部署中的自主成功、失败和人工纠正统一纳入训练,通过价值函数估计动作优势,再让VLA条件化地模仿正优势行为,使通用模型可以在部署后持续提高成功率和任务吞吐量。
RECAP先用离线强化学习预训练支持优势条件的通用VLA,再在目标任务上收集自主轨迹与专家介入。价值函数比较动作前后的任务进度,将样本标为正或负优势;推理时显式要求策略生成“positive advantage”行为。实验覆盖折衣、纸箱组装和商业咖啡机操作,困难任务的单位时间完成量可提高到两倍以上,整体失败率约减半。
优势是能够利用传统行为克隆经常丢弃的失败和纠正数据,并避免直接对大型flow VLA运行不稳定、昂贵的在线PPO。它优化的不只是最终成功率,还包括效率和错误恢复。局限是仍需人工判定成功、重置环境和提供部分干预,价值估计错误也可能强化错误行为;方法更适合把已有技能打磨为高可靠专家,而不是从零探索全新技能。
补上了缺少的部署学习闭环,而把类似思想前移到大规模预训练:不必丢弃失败和次优数据,只需用质量、错误和速度条件明确区分它们。Cosmos Policy也学习价值并用候选未来进行规划,但它依赖显式世界预测;RECAP则通过优势标签直接重塑动作分布。两者分别代表“经验驱动的策略改进”和“模型驱动的候选选择”
: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities
https://arxiv.org/abs/2604.15483 https://www.songbozhang.top/article/dollarpi07dollar
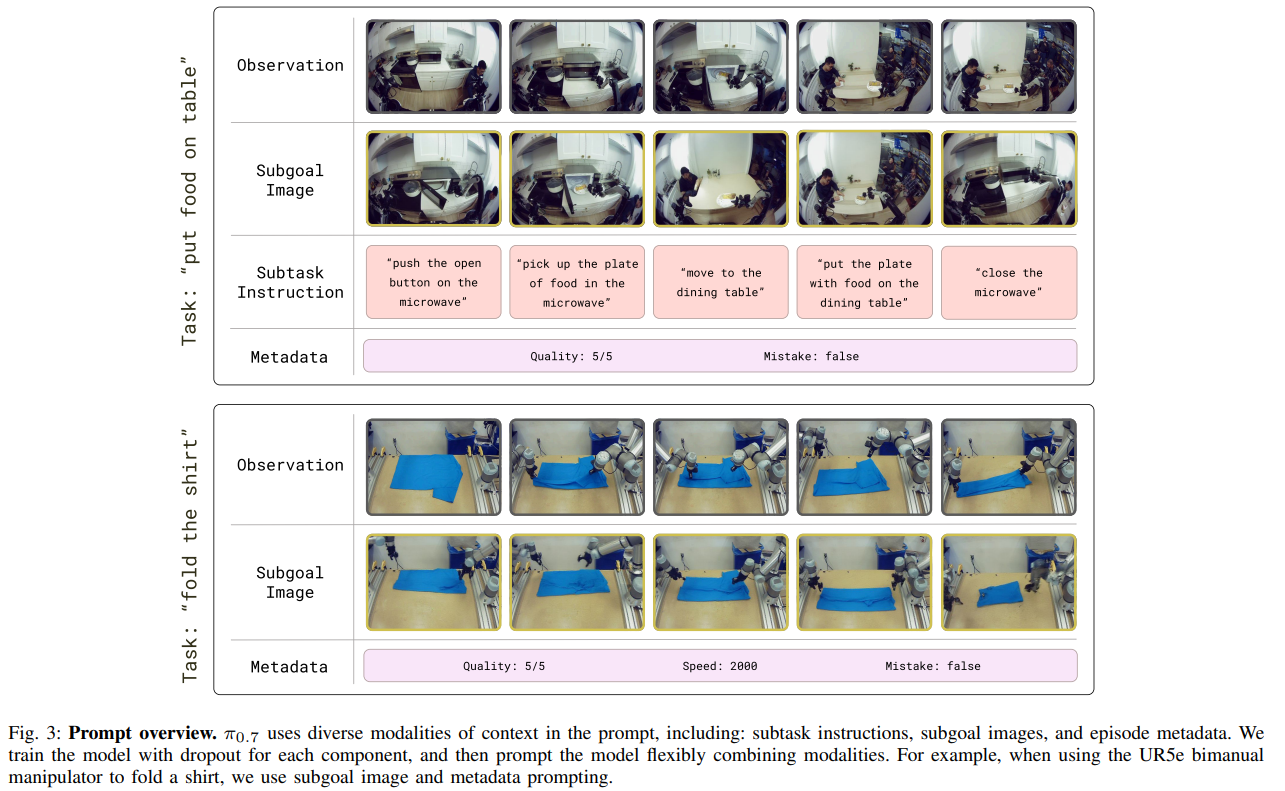 提出“可操纵的通用策略”:模型不仅接收任务语言,还接收子任务、未来视觉目标、速度、质量评分、错误标记和控制模式等多模态上下文。这样,高质量演示、失败轨迹、自动执行、跨机器人数据和非机器人视频不再被混成一个模糊平均分布,而是成为可以在测试时选择的不同条件行为模式。
模型延续VLM主干和flow-matching action expert,并加入历史视觉、高层语言策略及视觉子目标生成模块。训练时随机丢弃部分条件,使系统可灵活接受不同提示组合;部署时指定高质量、无错误等条件,引导模型采用更优策略。论文展示了新环境中的复杂语言执行、零样本跨具身折衣、未专门采集任务的组合泛化,以及接近任务专用RL模型的开箱即用表现。
这项工作的优势不是某个单一网络部件,而是异构数据治理范式:失败数据不必删除,关键是显式描述其行为属性。视觉子目标也补足语言难以表达抓取点、姿态和几何关系的问题。
综合了本页多条路线:继承的连续控制、的层级任务、对优劣经验的区分,同时把“Thinking with Images”落实为视觉子目标条件。它与DreamZero等WAM的差别是,未来视觉主要作为可控提示,而不是与动作共同生成的内部世界状态;因此它更像“由世界模型辅助的强VLA”,而不是完整的世界—动作联合模型
end2end
LingBot-VLA:A Pragmatic VLA Foundation Model
https://arxiv.org/pdf/2601.18692v4 https://www.songbozhang.top/article/lingbot-vla
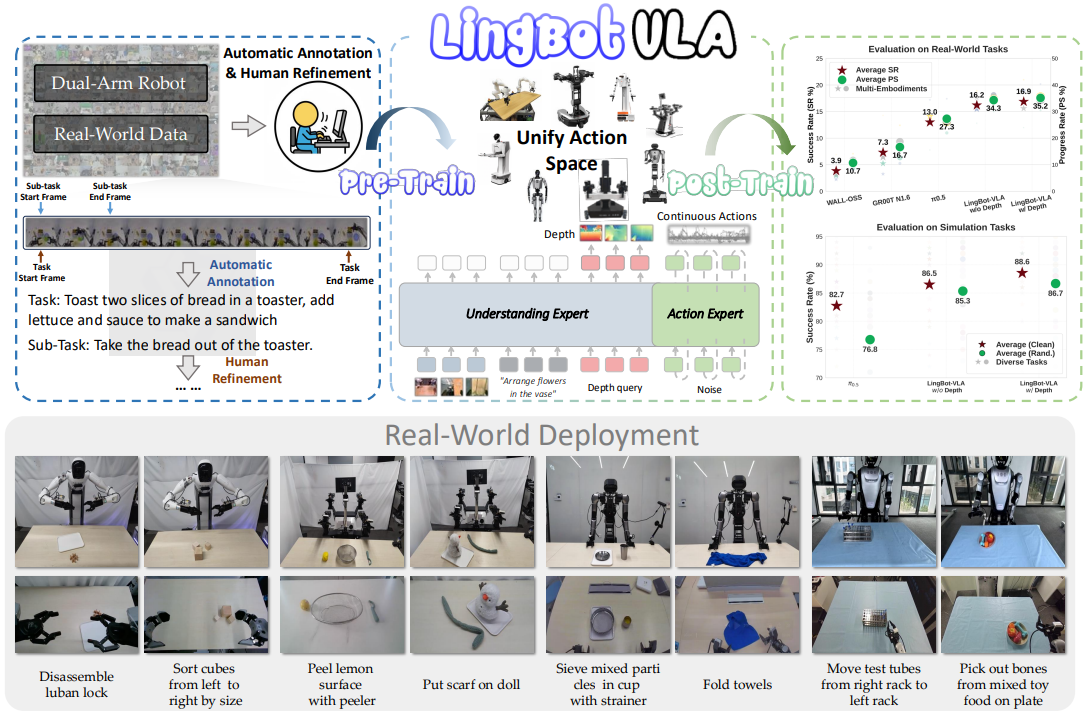
采用理解专家与动作专家组成的Mixture-of-Transformers,并提供高吞吐开源训练代码、基础模型和大规模评测数据
理解专家基于Qwen2.5-VL处理图像和语言,动作专家处理机器人状态与带噪动作,两者逐层交换信息并用flow matching生成50步连续动作。模型还通过深度蒸馏使RGB特征保留三维信息。论文在多个平台上以每个平台100项任务和每任务固定后训练数据进行系统评估,并报告从3000小时扩展到20000小时时性能仍持续增长。
架构与的VLM—action expert路线一致
分层
Gemini Robotics: Bringing AI into the Physical World
https://arxiv.org/abs/2503.20020 https://www.songbozhang.top/article/gemini-robotics
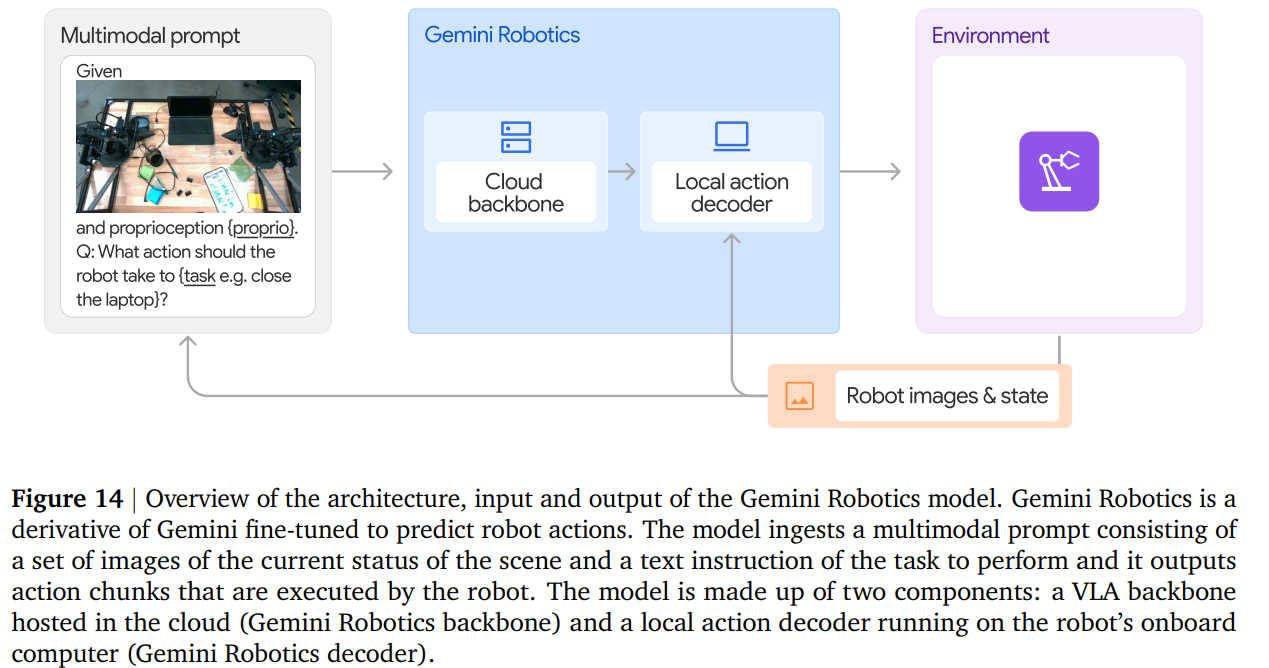
Gemini Robotics把Gemini 2.0的多模态能力扩展为机器人模型家族:Gemini Robotics-ER负责具身空间与时间推理,Gemini Robotics负责直接生成动作。系统强调语义理解、空间定位、反应式控制和少样本适配,展示了开放词汇指令、未见物体与环境以及新机器人形态上的广泛泛化
Robotics-ER提供检测、指点、抓取、轨迹、多视角对应和三维框等具身推理能力;VLA模型则在Gemini基础上增加机器人动作输出,并通过动作分块和本地执行降低大模型推理与网络延迟。经过少量示范后,模型可学习新的短任务;进一步微调后可以完成长程、高精度和高灵巧操作
优势是高层世界知识、空间推理和实时动作的分层组合,尤其适合开放指令和跨场景迁移。局限是系统高度闭源,云端大模型与本地控制的分割会引入部署、隐私和连接可靠性问题
Gemini Robotics与都采用高层语义决策和低层动作执行,但Gemini更明确地区分ER推理模型与动作模型
Video Model
DreamGen: Unlocking Generalization in Robot Learning through Video World Models
https://arxiv.org/abs/2505.12705 https://www.songbozhang.top/article/dreamgen
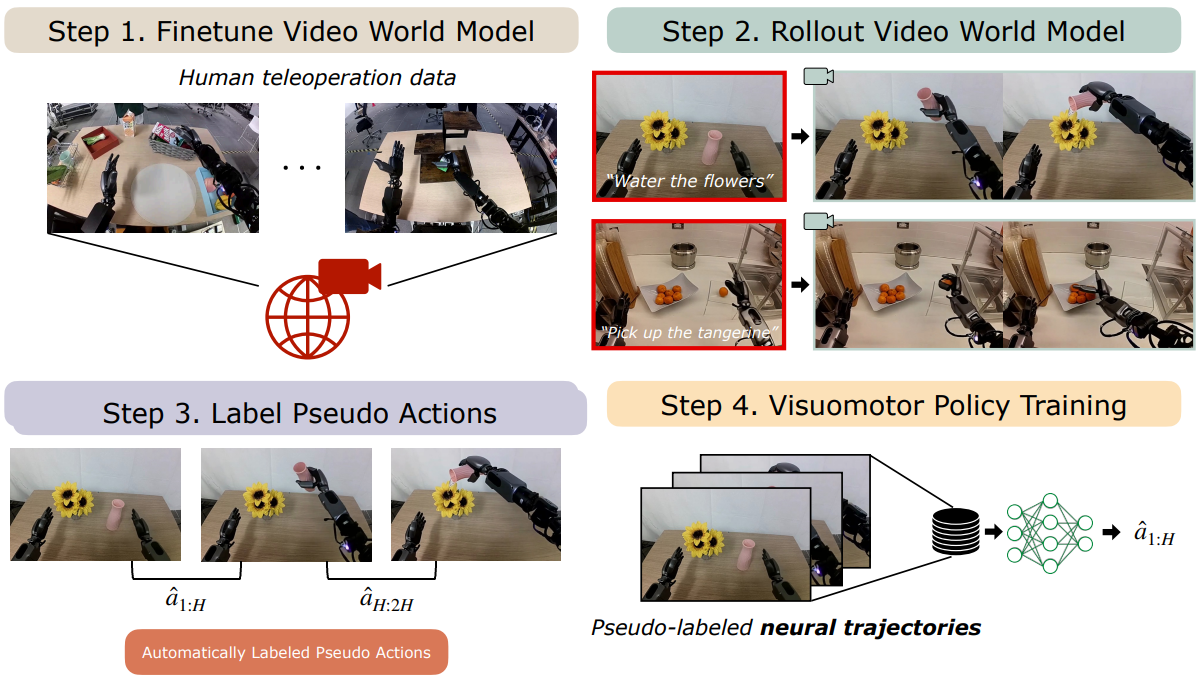
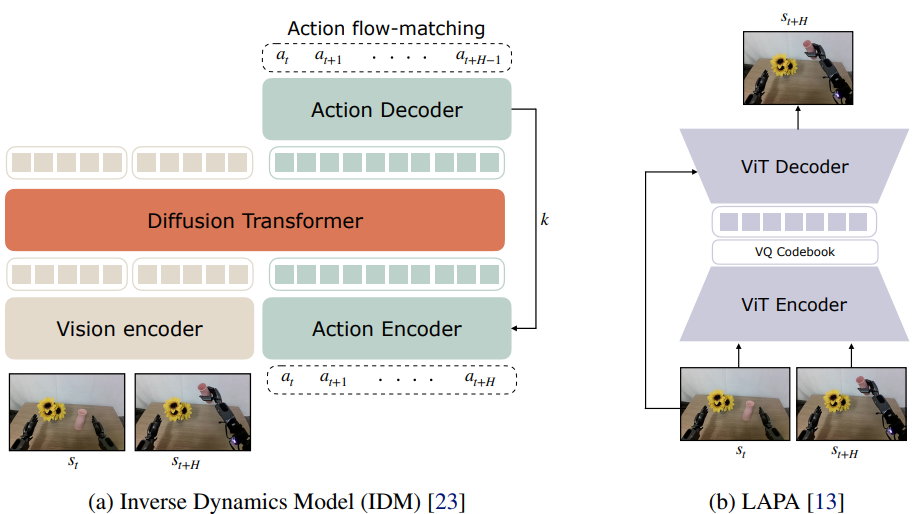
DreamGen把视频世界模型作为离线机器人数据生成器,用少量目标机器人视频适配通用图生视频模型,再生成新任务、新场景和新物体中的“神经轨迹”。由于合成视频没有动作标签,系统通过逆动力学模型或潜动作模型恢复伪动作,最后用这些视频—动作对训练常规机器人策略
四阶段流程包括机器人外观适配、条件视频生成、伪动作恢复和策略训练。IDM直接预测目标机器人的连续动作,但需要真实动作数据;潜动作方法不依赖机器人动作标签,却只提供抽象运动表征。论文展示了仅从一个环境中的单一拾放遥操作任务出发,让人形机器人在已见和未见环境中执行22种新行为,并提出DreamGen Bench评估视频生成质量与下游策略表现的关系
优势是把昂贵的机器人数据收集转化为可扩展的视频生成,部署时又无需运行大型视频模型。局限是生成视频的物理错误和伪动作误差会叠加;视频模型可能生成外观正确但机器人不可执行的轨迹;整个过程是离线扩增,无法在执行时根据真实反馈修正模拟
DreamGen首次清晰连接了视频世界模型与VLA训练
Cosmos
Cosmos WFM
https://arxiv.org/abs/2501.03575 https://www.songbozhang.top/article/cosmos-wfm
Cosmos WFM的意义不是一个孤立的视频生成模型,而是一套Physical AI世界基础模型平台:它包含大规模视频清洗与描述、连续和离散视频tokenizer、扩散与自回归世界模型、领域后训练、安全过滤以及开放权重
最大优势是平台化和开放性:它把数据、表示、模型、后训练和安全接口放入同一技术栈
Cosmos系列后续工作逐步修补初代平台的接口缺口:Transfer1加入结构可控性,Reason1加入物理语义与具身推理,Predict2.5把推理重新接入生成,Cosmos 3把动作提升为一级模态
Cosmos-Reason1
https://arxiv.org/pdf/2503.15558 https://www.songbozhang.top/article/cosmos-reason1
Cosmos-Reason1 的主要创新不在模型架构,而在于建立了一套 ontology-driven(由能力本体驱动)的 Physical AI 数据构造、后训练和评测体系
定义物理常识和具身推理能力本体,训练多模态模型从视频中理解空间、时间、因果、物体状态和行动可供性,并以自然语言给出长推理过程与下一步高层决策
模型经历视觉预训练、通用SFT、Physical AI SFT和Physical AI RL四阶段训练。专用数据覆盖机器人、驾驶、直觉物理和动作后果推理,RL使用可验证的答案正确性与格式奖励。混合Mamba—Transformer结构用于兼顾长视频效率和全局关系建模。实验表明,Physical AI专项SFT和RL显著提升物理常识与具身推理基准表现。
优势是把“物理推理”拆成可训练、可评测的能力,而不是只依赖视频生成损失期待模型自动涌现因果知识。局限是奖励主要针对选择题和文本格式,距离真实动作是否安全、可执行、成功仍很远;输出是语言决策而非连续控制;均匀采样有限视频帧也可能遗漏快速接触事件。长思维链提高答题能力,不必然代表内部建立了可用于控制的因果模型。
Cosmos-Transfer1
https://arxiv.org/pdf/2503.14492 https://www.songbozhang.top/article/cosmos-transfer1
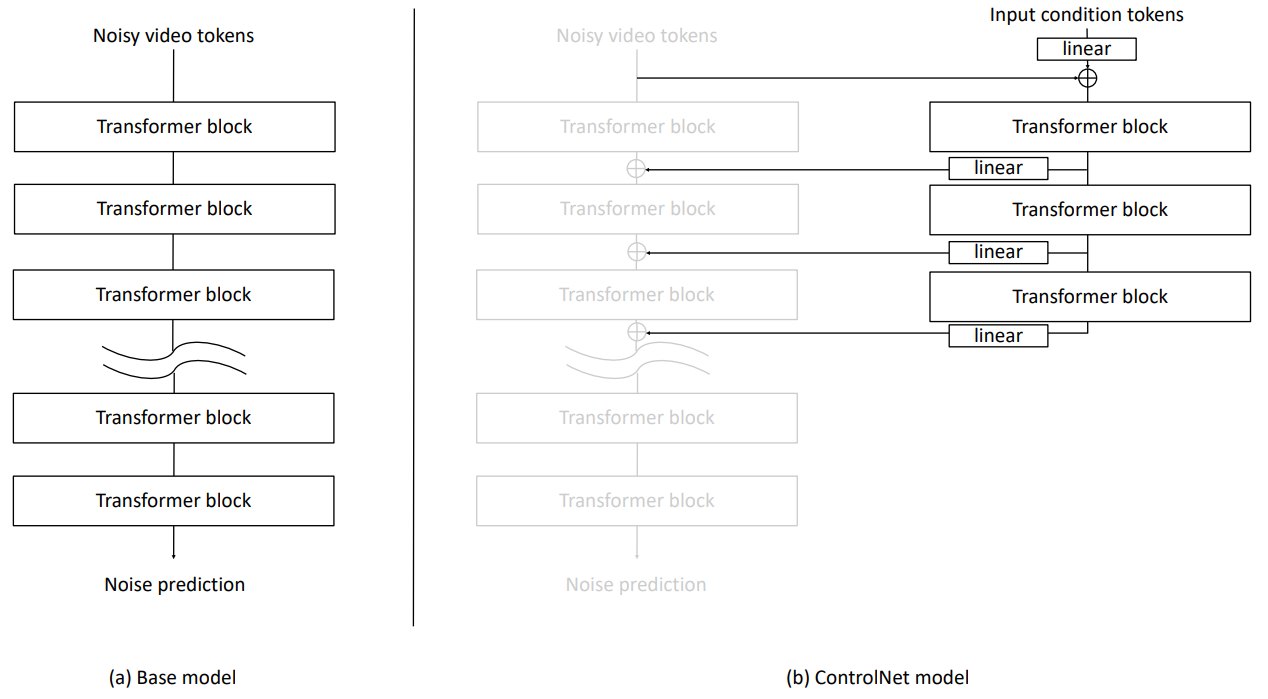
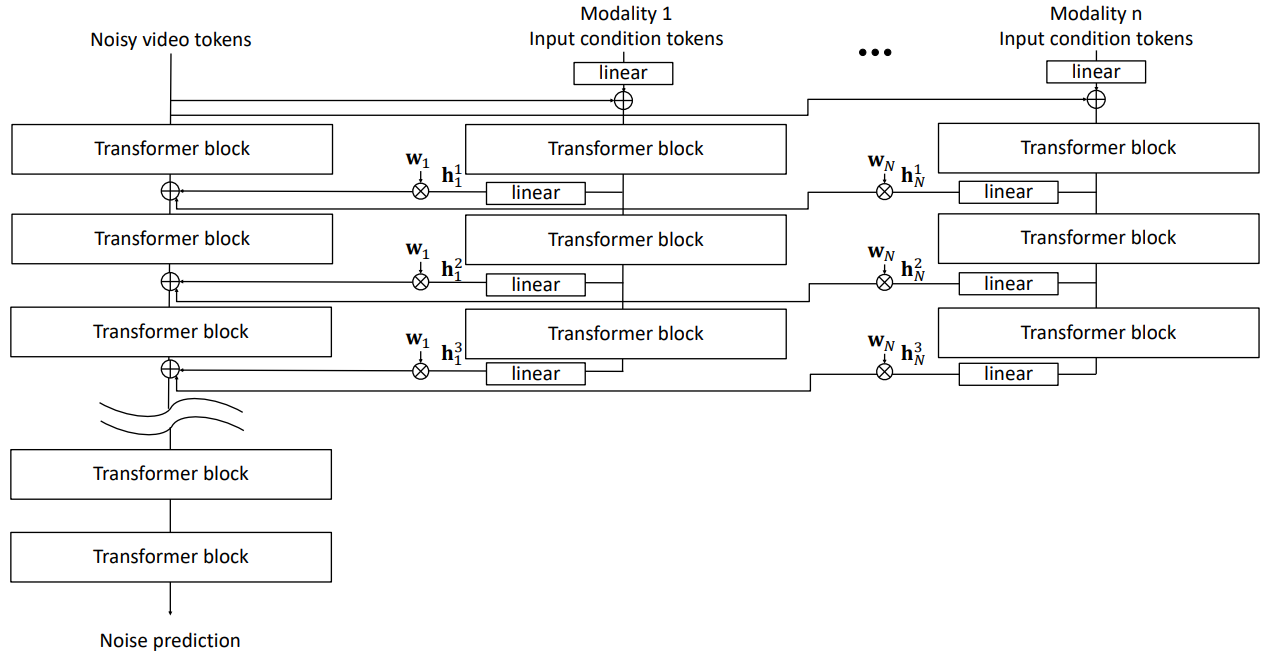
Cosmos-Transfer1解决初代世界模型“能生成但难精确控制”的问题。它允许深度、边缘、分割、视觉、LiDAR和地图等多种条件分别约束不同空间区域和时间位置,从而在保留模拟器几何与动作结构的同时改变材质、天气、光照和背景外观
模型建立在冻结的Cosmos-Predict1视频扩散主干上,每种控制模态拥有独立ControlNet式分支,推理时通过时空变化的权重组合。机器人区域可强调边缘以保持机械臂形状,背景可强调深度或分割以增加外观多样性。论文展示了机器人Sim2Real和自动驾驶数据增强,并通过大规模GPU系统实现接近视频时长的高吞吐生成
优势是模块化和可组合:新控制模态不必重训整个生成模型,结构约束和生成自由度也可按区域平衡。局限是控制权重多由人工规则或外部模型设定,没有根据最终策略收益端到端学习
Transfer1直接补足Cosmos WFM缺乏结构约束的问题
Cosmos-Predict2.5/Cosmos-Transfer2.5
https://arxiv.org/abs/2511.00062 https://www.songbozhang.top/article/world-simulation-with-video-foundation-models-for-physical-ai
Predict2.5以flow架构在单一模型中统一Text2World、Image2World和Video2World,并使用Cosmos-Reason1提供更丰富的物理语义条件;Transfer2.5则延续可控世界转换,但以更紧凑的控制块布局获得更高效率和长程一致性
Predict2.5在约两亿段筛选视频上训练,结合强化学习式后训练提高画质与指令对齐,并发布2B和14B版本。Transfer2.5采用类似ControlNet的结构,但把控制模块分散注入不同深度的主干层
Cosmos3
https://arxiv.org/abs/2606.02800 https://www.songbozhang.top/article/cosmos
Cosmos 3把语言、图像、视频、音频和动作统一到Mixture-of-Transformers框架中,使同一模型能够承担多模态理解、视频生成、世界模拟、逆动力学和机器人策略。最重要的质变是动作成为一级模态:模型既可给定动作预测未来,也可给定状态变化反推动作,或联合生成动作及其预期视觉后果
架构为自回归语言/推理序列和扩散式视觉、音频、动作序列保留专业参数,同时通过共享注意力交换上下文
Cosmos 3是该系列各分支的汇合:继承Cosmos WFM的视频平台、Transfer的控制、Reason1的推理和Predict2.5的任务统一,再加入原生动作token
DreamDojo
https://arxiv.org/abs/2602.06949v1 https://www.songbozhang.top/article/dreamdojo
DreamDojo利用约4.4万小时第一视角人类视频预训练通用机器人世界模型,核心突破是从无动作标签视频中学习连续潜动作,把人类交互中的丰富物体、场景和技能知识迁移给机器人。少量目标机器人数据只需完成动作接口适配,不必从头学习完整世界动态。
系统先从相邻视频变化中提取低维潜动作,训练动作条件世界模型;随后用目标机器人的真实动作替换潜动作输入并后训练;最后通过因果、自回归和少步扩散蒸馏达到约10.81 FPS
优势是充分利用人类视频这一远大于机器人轨迹的数据源,并用潜动作避免依赖每个视频数据集的手部骨架或动作捕捉标签
World Action Model
Cosmos Policy
https://arxiv.org/abs/2601.16163 https://www.songbozhang.top/article/cosmos-policy
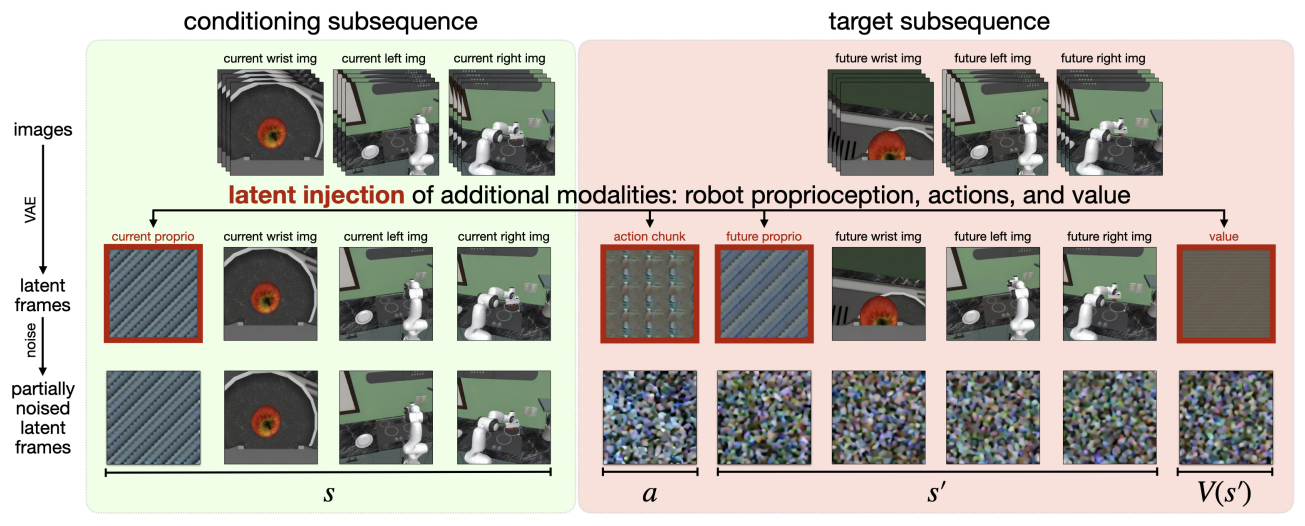
Cosmos Policy展示了一条极简的WAM路线:无需为视频模型增加专用动作架构,只需把机器人状态、动作、未来图像和价值编码为与视频潜帧形状一致的张量,并对预训练Cosmos-Predict2进行一次目标平台后训练。一个扩散Transformer由此同时成为策略、世界模型和价值函数。
优势是结构简单、训练阶段少,并且策略、世界预测和价值共享表示,减少传统流水线中的误差传递
DreamVLA
https://arxiv.org/abs/2507.04447
https://www.songbozhang.top/article/dreamvla
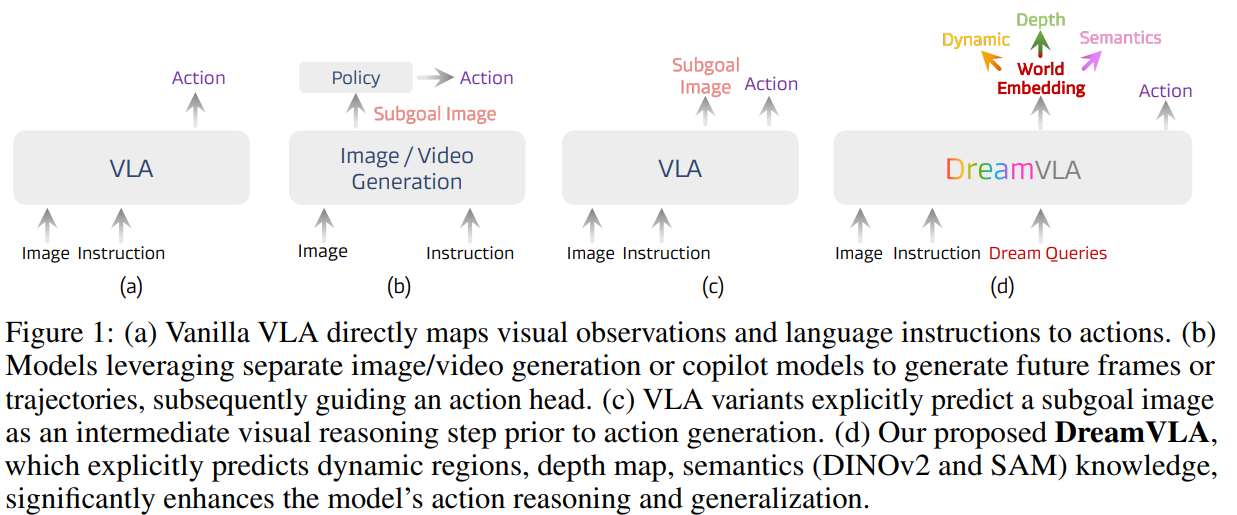
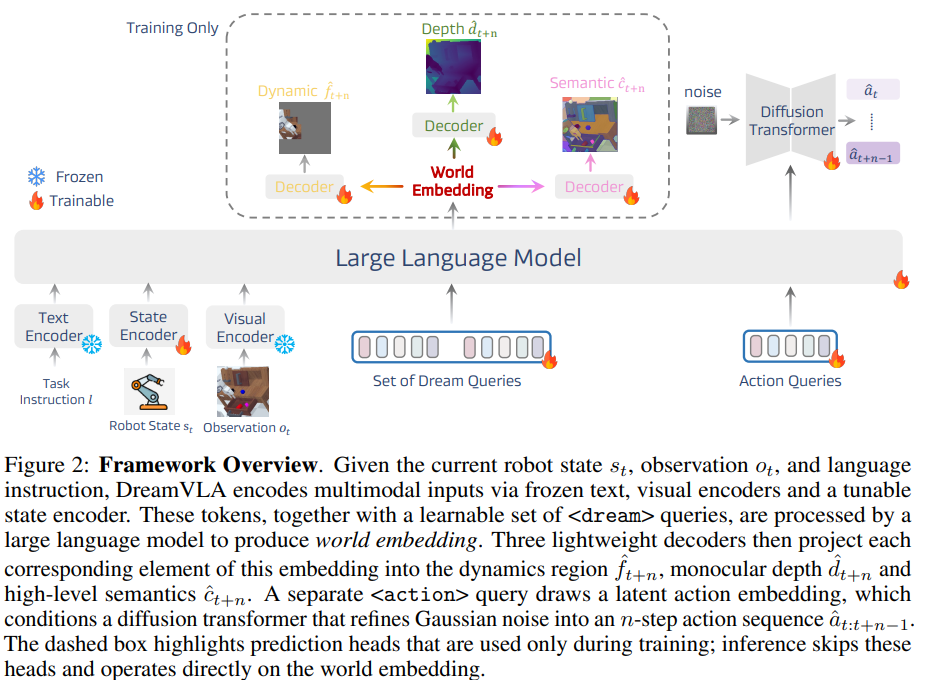 DreamVLA位于传统VLA与完整WAM之间。它认为生成完整未来RGB视频包含大量静态背景和无关像素,因此只预测与控制最相关的三类未来知识:动态区域、深度关系和语义特征,再以这些紧凑表示条件化扩散动作生成
多模态编码器融合语言、多视角图像和机器人状态,三组Dream Query分别学习动态、深度和语义未来;block-wise attention限制三种表示互相泄漏,Action Query再聚合它们生成动作。辅助解码器和伪标签仅用于训练,部署时可移除,因此推理不必真正渲染未来图像。
优势是用紧凑、任务相关的世界知识代替高成本像素生成,在有限算力下兼顾未来预测和动作质量。局限是动态、深度和语义监督依赖CoTracker、Depth Anything、SAM等模型的伪标签;推理时中间知识不再显式输出,难以检查模型是否真的预测正确
DreamZero
https://www.songbozhang.top/article/world-action-models-are-zero-shot-policies https://arxiv.org/abs/2602.15922
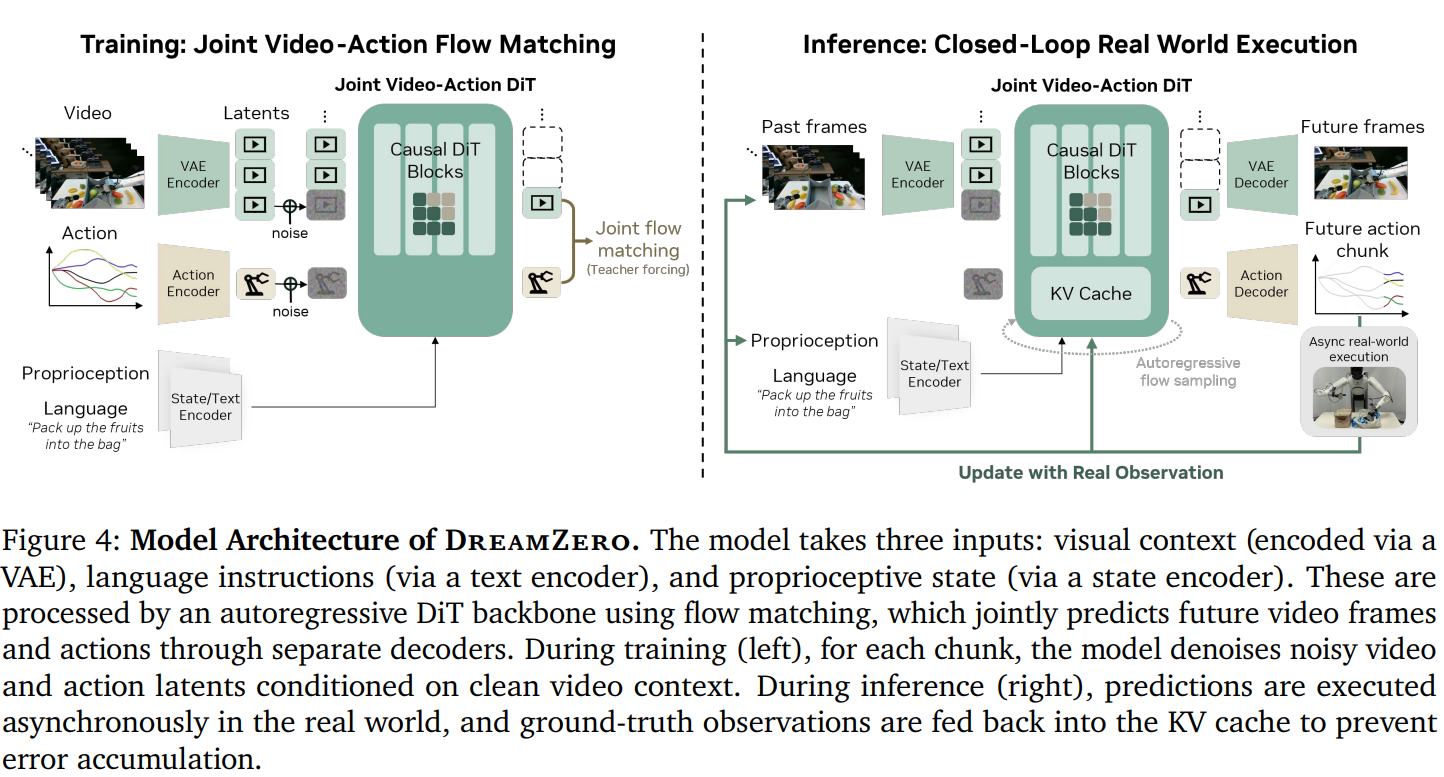
DreamZero的核心创新不是“造了一个新模型结构”,而是证明“现有大视频模型经过正确的动作接口、联合目标和闭环系统设计后,可以直接成为泛化很强的机器人策略”。
DreamZero提出World Action Model本身可以成为零样本策略。模型以大型预训练视频扩散骨干为基础,端到端联合生成未来视频和机器人动作:视频分支充当隐式视觉规划器,动作分支充当逆动力学模型,从而弥补静态图文VLA擅长语义、却不擅长新物理动作的缺口。
系统基于14B图生视频模型,使用flow matching共同去噪未来视频潜变量和动作块,并以自回归chunk方式运行。执行后,真实相机观测会替换缓存中的预测画面,避免视频误差无限累积。通过异步执行、缓存、量化、编译和单步动作去噪,模型达到约7 Hz闭环控制。
Motubrain: An Advanced World Action Model for Robot Control
https://arxiv.org/abs/2604.27792 https://www.songbozhang.top/article/motubrain
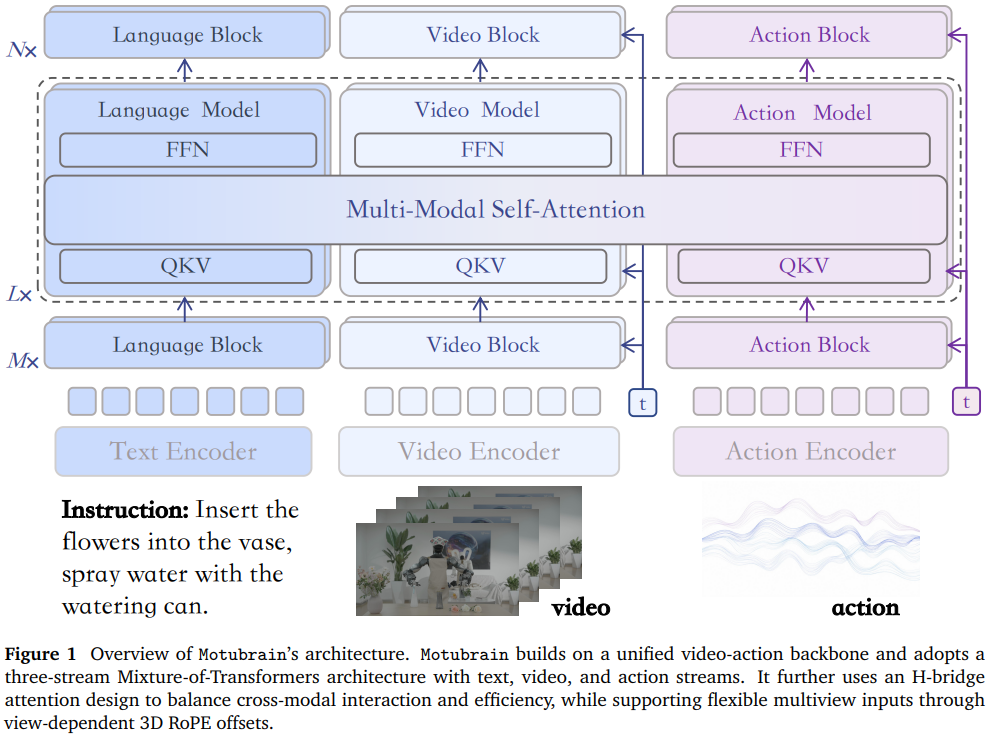
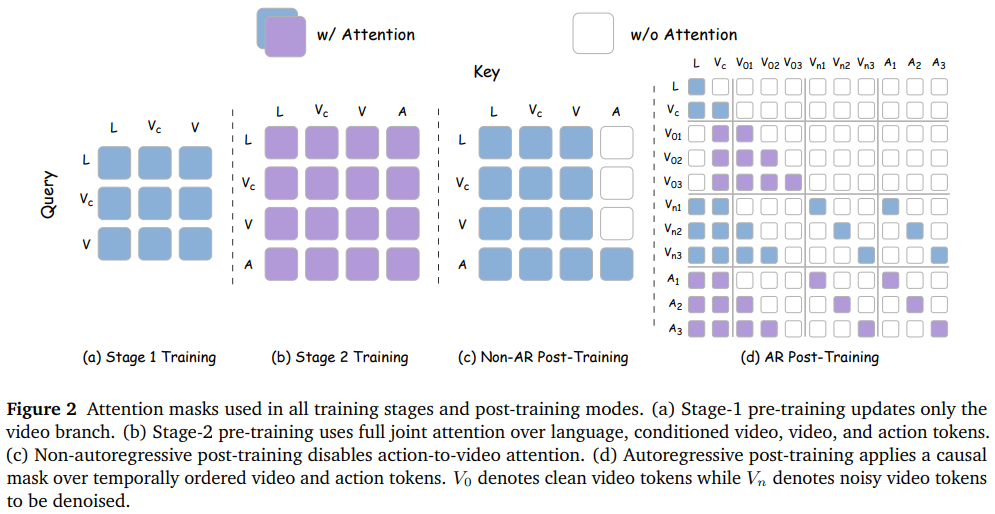
MotuBrain提出统一的World Action Model,以UniDiffuser和三流Mixture-of-Transformers联合建模文本、视频和动作。通过改变条件与生成变量,同一个模型可以执行VLA策略、动作条件世界预测、语言视频生成、逆动力学和视频—动作联合生成,目标是在通用性、预测能力和真实机器人实时控制之间取得平衡
文本、视频和动作拥有独立专家流,并在中间层通过H-bridge跨模态注意力交换信息;多视角视频用带视角偏移的3D RoPE统一处理;不同机器人动作被转换成相对末端执行器表示
优势是功能完整且重视部署:模型既能“想象未来”又能在后续去噪阶段只生成动作,避免每一步都完整渲染视频;相对末端表示也降低跨机器人适配成本
MotuBrain可以视为本页多条路线的工程汇合:继承Diffusion Policy和的连续生成,吸收DreamZero的视频—动作联合思想,并在架构上与Cosmos 3的多流专家统一相呼应
Spatial Reasoning
Data Scaling
Scaling Spatial Reasoning in MLLMs through Programmatic Data Synthesis
https://arxiv.org/abs/2512.16237
Scaling Spatial Intelligence with Multimodal Foundation Models
https://arxiv.org/abs/2511.13719
Visual Spatial Tuning
https://arxiv.org/abs/2511.05491
Task Customizing
Spatial-SSRL: Enhancing Spatial Understanding via Self-Supervised Reinforcement Learning
https://arxiv.org/abs/2510.27606
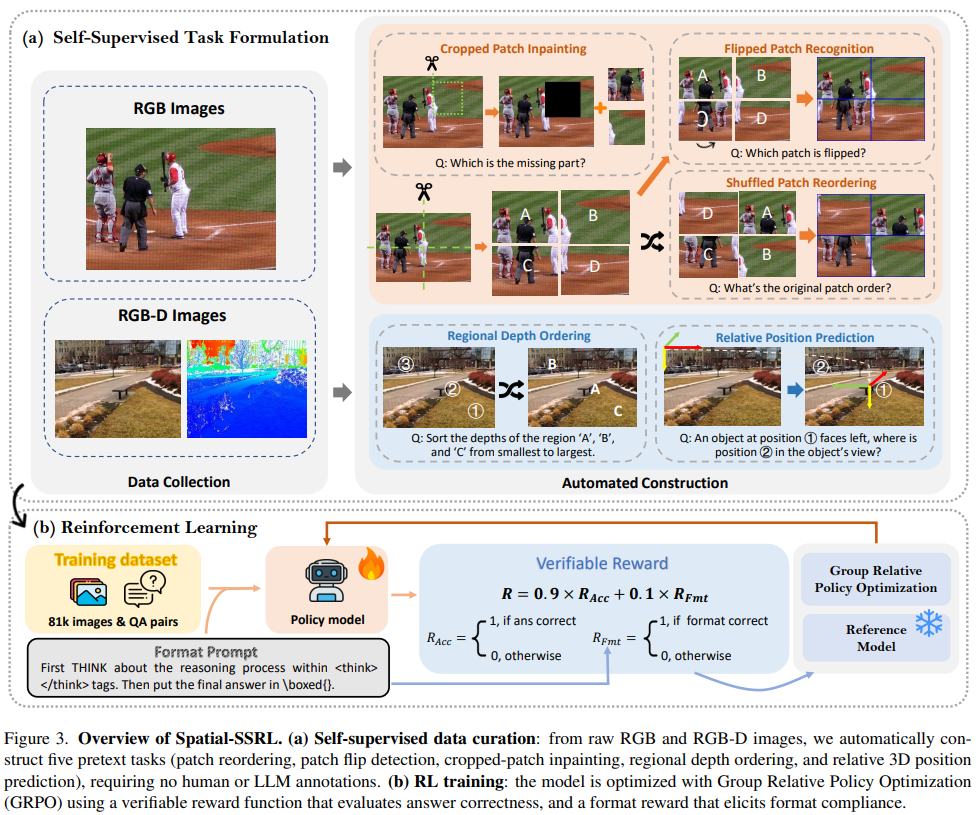
通过对图片进行变换来做一个自监督学习来提升空间推理的效果
Euclid's Gift: Enhancing Spatial Perception and Reasoning in Vision-Language Models via Geometric Surrogate Tasks
https://arxiv.org/abs/2509.24473
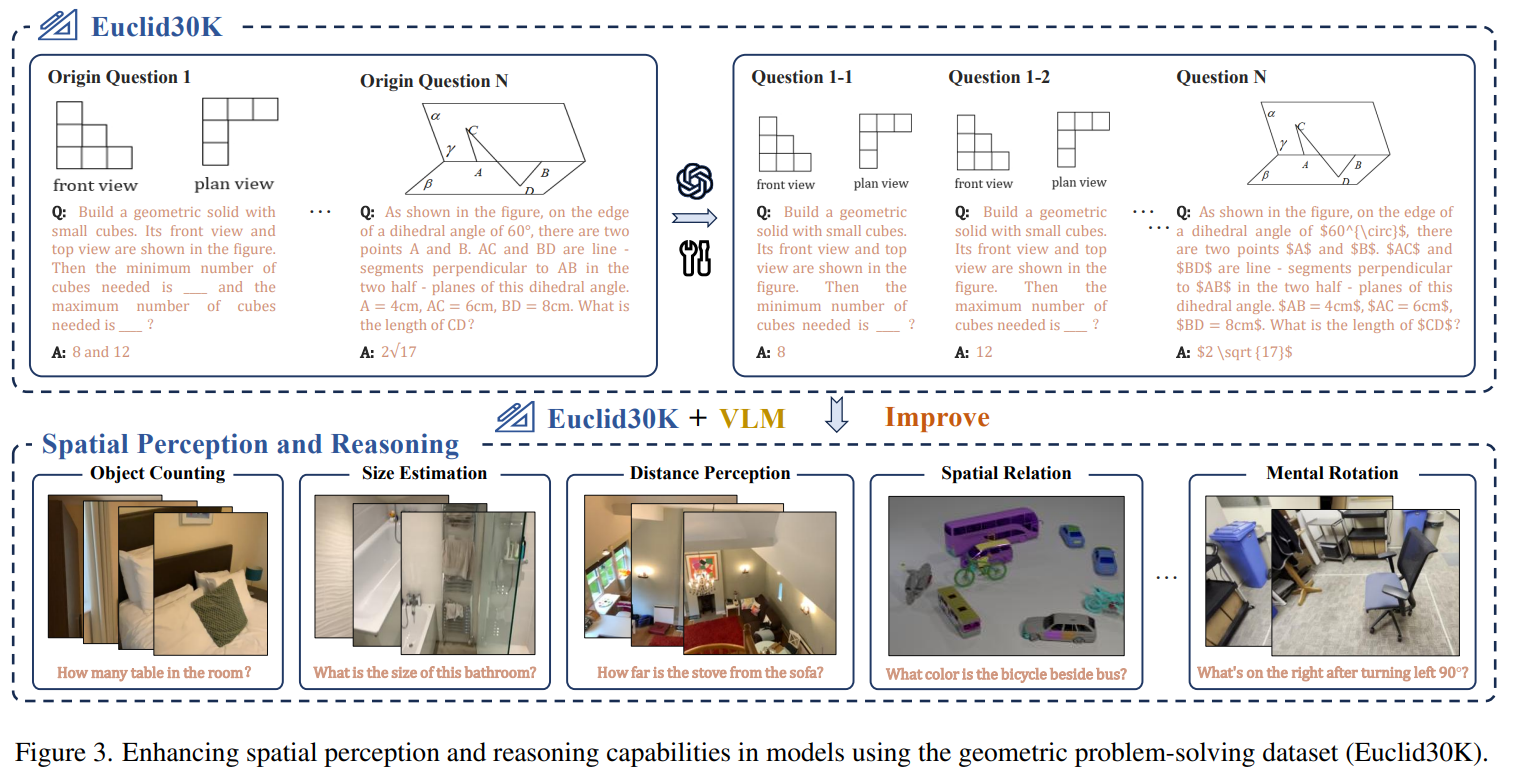
认为从欧几里得几何题目中能够获得空间推理的增强,构造了二维三维的几何题目数据集,在此基础上作GRPO,然后发现真的能提升性能