论文笔记 · 2026/07/24
MotuBrain
Motubrain: An Advanced World Action Model for Robot Control
https://arxiv.org/pdf/2604.27792
Motubrain: An Advanced World Action Model for Robot Control
1. 论文解决了什么问题
现有 Vision-Language-Action(VLA)模型通常直接将视觉观察和语言指令映射为机器人动作:
这类模型具有较强的语义理解能力,但往往缺乏对接触、物体运动和动作后果等细粒度世界动态的建模,因此在长程操作、复杂物理交互、环境变化和跨机器人迁移中容易失效。
MotuBrain 要解决的核心问题是:如何让同一个模型既理解“机器人应该做什么”,又理解“执行动作后世界会怎样变化”,同时还能满足真实机器人实时控制的速度要求
2. 使用什么方法解决
论文提出统一的 World Action Model,不再单独学习从观察到动作的映射,而是联合建模未来视频与机器人动作:
其中 (c) 是当前视觉观察,(l) 是语言指令,(v) 是未来视频,(a) 是未来动作。
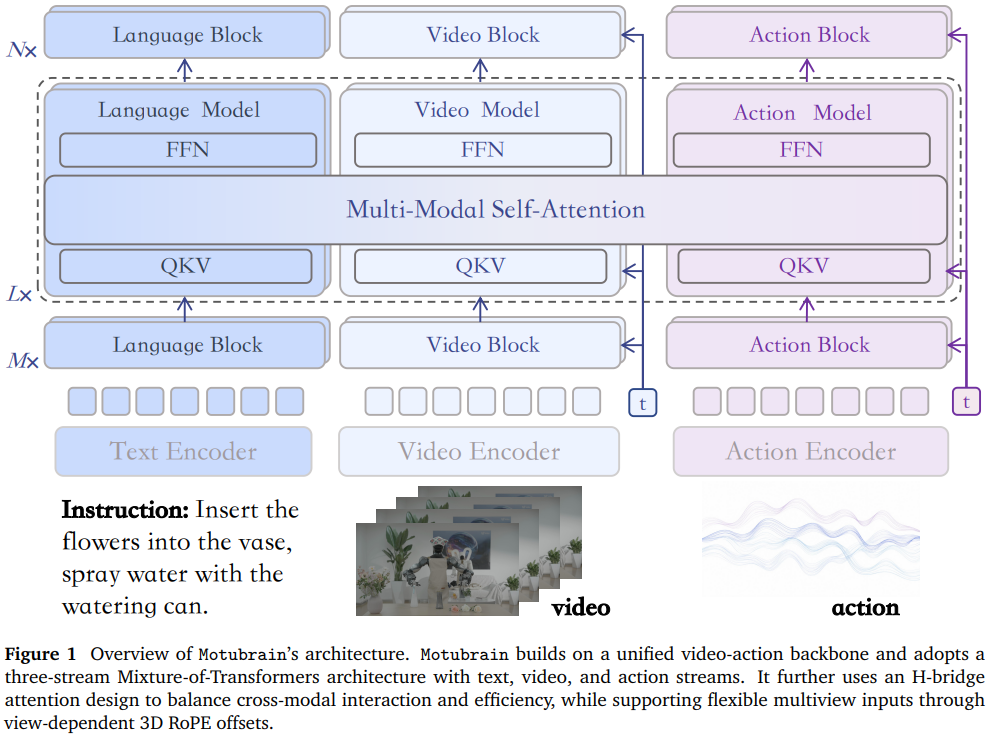
模型基于 UniDiffuser,将视频和动作视为两种连续生成模态,并使用 flow matching 同时学习二者的去噪过程。通过改变哪些变量已知、哪些变量需要生成,同一个模型能够执行五种任务:
- VLA 动作策略;
- 动作条件世界预测;
- 语言条件视频生成;
- 根据未来视频反推动作;
- 联合生成未来视频和动作
3. 具体技术设计
3.1 三流 Mixture-of-Transformers
模型设置三条独立的信息流:
- 文本流:处理语言指令,持续为其他模态提供语义条件;
- 视频流:处理当前图像和带噪未来视频潜变量;
- 动作流:生成末端执行器运动和夹爪状态。
三条信息流在 Transformer 中交换信息,使语言目标、视觉动态和机器人动作直接对齐
3.2 H-bridge 跨模态注意力
为了降低视频—动作联合注意力的计算成本,模型只在中间50%的 Transformer 层中执行完整的视频—动作交互;底部和顶部各25%的层分别处理视频与动作。
这种设计在保留跨模态对齐能力的同时,减少了计算量,并保留各模态自身的表示结构
3.3 可变数量的多视角输入
不同摄像头画面分别经过 VAE 编码,再在 token 维度拼接。模型通过带有视角空间偏移的 3D RoPE 区分不同相机,因此无需修改主干网络即可处理不同数量的头部、腕部或外部摄像头
3.4 分层预训练与跨本体动作表示
训练数据按照以下层次组织:
模型先利用 Vidu 视频模型获得通用世界动态知识,再学习机器人操作视频,最后学习动作。
不同机器人平台的动作被统一转换为相对于当前条件帧的末端执行器变化,包括相对位置、相对旋转和夹爪状态。该 Relative EEF 表示减少了机器人尺寸、初始位置和控制接口差异,使模型能够利用跨本体数据,并使用较少目标机器人轨迹完成适配
3.5 Non-AR 与 AR 两种控制方式
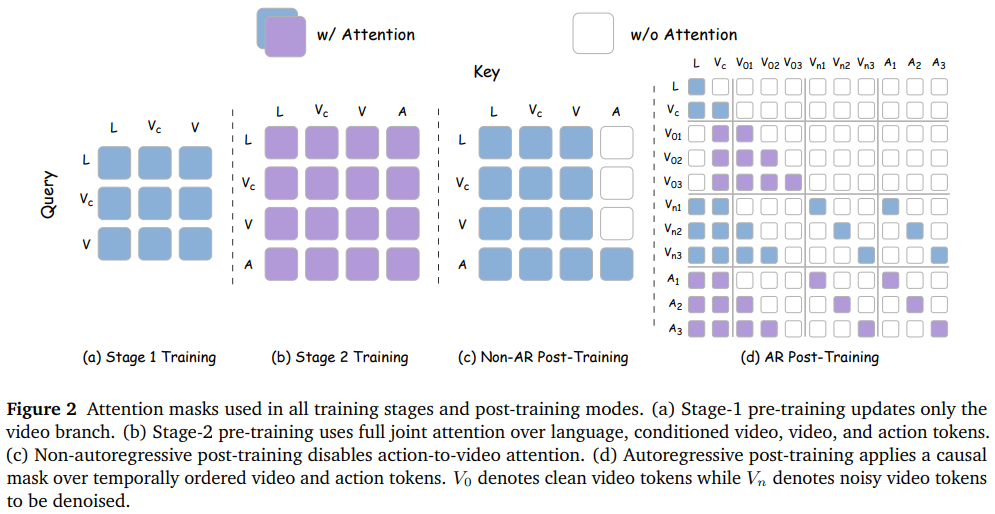
Non-AR 模式一次并行生成完整动作块,延迟较低,适合短时间、高频控制。
AR 模式以动作块为单位进行自回归生成,每次执行一部分动作后重新读取真实视觉观察,再生成下一动作块,因此更适合分钟级、多阶段长程任务
3.6 V2A 与实时部署
MotuBrain 在后训练中采用非对称的 Video-to-Action 注意力:
- 动作可以读取视频信息;
- 视频不依赖动作 token。
推理时先进行少量视频—动作联合去噪,随后冻结视频表示,只继续生成动作。这使模型能够利用世界预测能力,却不必在每个采样步骤中完整生成未来视频。
在此基础上,论文结合减少采样步数、模型编译、FP8量化、DiT缓存、动作块异步执行和新旧动作平滑融合,将推理延迟从4.90秒降低到0.09秒,达到约11 Hz
4. 主要创新点
MotuBrain 的主要创新可以归纳为四点:
- 统一世界建模与动作生成:同一个模型同时学习未来视觉变化和机器人动作,而不是把视频预测与动作控制拆成独立系统。
- 统一多种任务形式:一套参数即可切换为机器人策略、世界模型、视频生成模型、逆动力学模型或联合视频—动作模型。
- 统一异构数据与机器人本体:通过分层视频预训练、可变多视角设计和 Relative EEF 动作表示,利用互联网视频、第一人称视频和不同机器人平台的数据。
- 让扩散式世界动作模型具备实时部署能力:V2A action-only 推理、缓存、量化和异步动作块融合解决了世界模型计算量大、控制延迟高的问题
5. 主要结果与结论
MotuBrain 在 RoboTwin 2.0 的干净场景和随机化场景中分别取得 95.8% 和 96.1% 的平均成功率;在 WorldArena 比较中取得 63.77 的 EWMScore;模型还能使用约 50—100条目标机器人轨迹适配新的机器人本体
论文的核心结论是:
机器人控制不应只学习“当前画面对应什么动作”,而应联合学习“动作如何改变世界”。MotuBrain 通过统一建模语言、视频与动作,将世界预测能力转化为可实时执行的机器人控制能力。