论文笔记 · 2026/07/24
: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities
: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities
https://arxiv.org/abs/2604.15483
概括
π₀.₇ 的核心思想是:通过更丰富的多模态提示,把不同任务、不同机器人、不同操作策略以及不同质量的数据区分开来,从而让一个通用机器人模型既能利用失败和次优数据,又能在测试时被引导为高质量行为
1. 论文解决的问题
现有视觉—语言—动作模型通常只根据场景和任务指令预测动作。当训练数据同时包含:
- 不同机器人和操作策略;
- 高质量演示与失败轨迹;
- 人工演示、自动执行和强化学习专家数据;
- 人类视频与互联网数据;
模型容易混淆这些行为模式,甚至把互相冲突的动作“平均”起来,导致动作缓慢、含糊或失败。因此,已有通用机器人模型往往仍需要针对具体任务微调,在新任务、复杂语言指令和跨机器人迁移上也较弱
2. 具体方法设计
2.1 丰富提示,而不只是增加数据
π₀.₇ 不仅输入“做什么”,还输入“怎样做”。其提示包含:
- 总体任务和当前子任务;
- 未来几秒应达到的视觉子目标;
- 执行速度;
- 整体质量评分;
- 当前动作片段是否包含错误;
- 机器人使用的控制模式。
这样,同一任务中的优秀、缓慢、失败或不同策略轨迹就被明确区分。测试时将质量设为最高、错误设为否,即可引导模型选择较好的行为模式
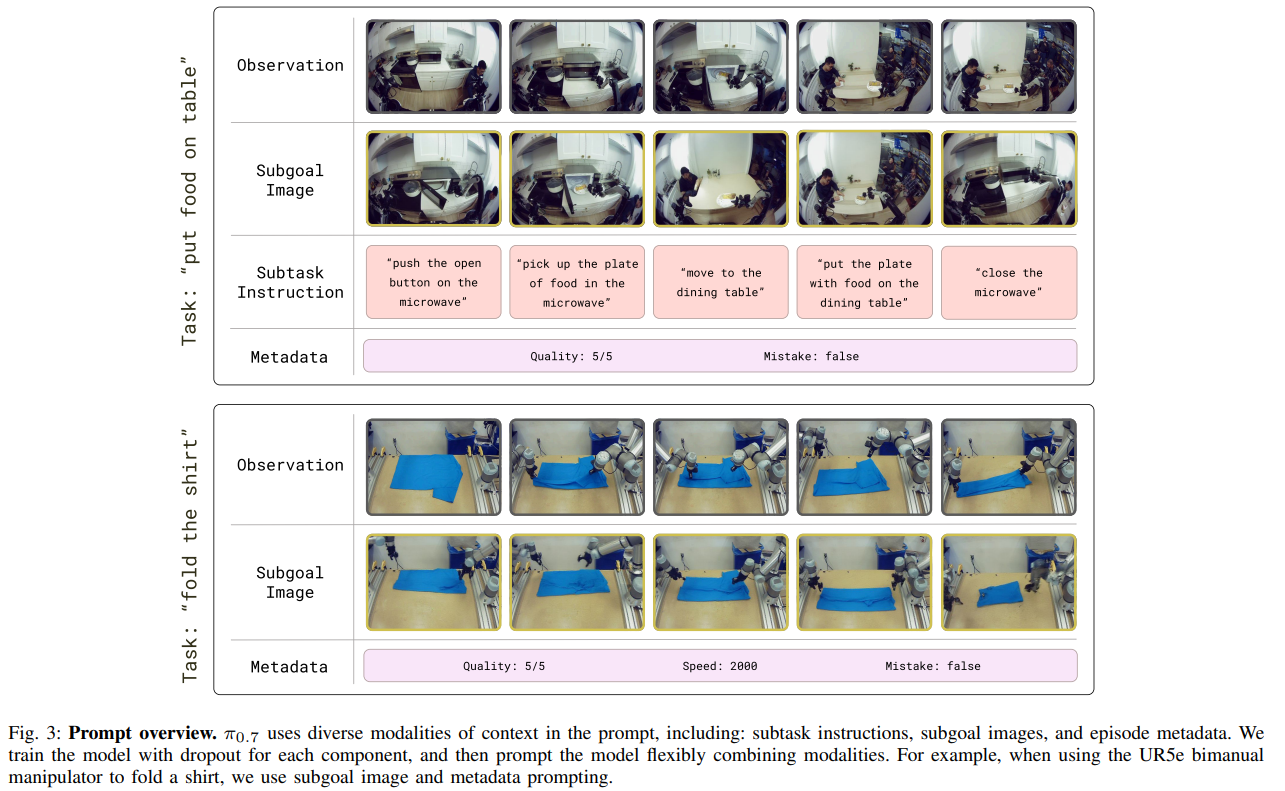
2.2 视觉子目标
语言只说明意图,往往不能准确描述抓取位置、手腕姿态和物体几何关系。π₀.₇ 因此使用世界模型生成未来理想画面,让低层策略根据:
生成多视角视觉子目标后,模型在复杂语言理解、跨机器人迁移和反常规指令上表现更好
2.3 模型与数据
π₀.₇ 是约 50 亿参数的 VLA,包括:
- 约 40 亿参数的视觉语言主干;
- 历史视觉编码器;
- 8.6 亿参数的流匹配动作专家;
- 高层语言策略;
- 基于 BAGEL 的视觉子目标生成模型。
训练数据包括人工演示、自动执行轨迹、失败数据、强化学习专家轨迹、人类第一视角视频和互联网多模态数据。训练时随机删除部分提示,使模型在运行时可以灵活使用语言、图像或元数据的不同组合
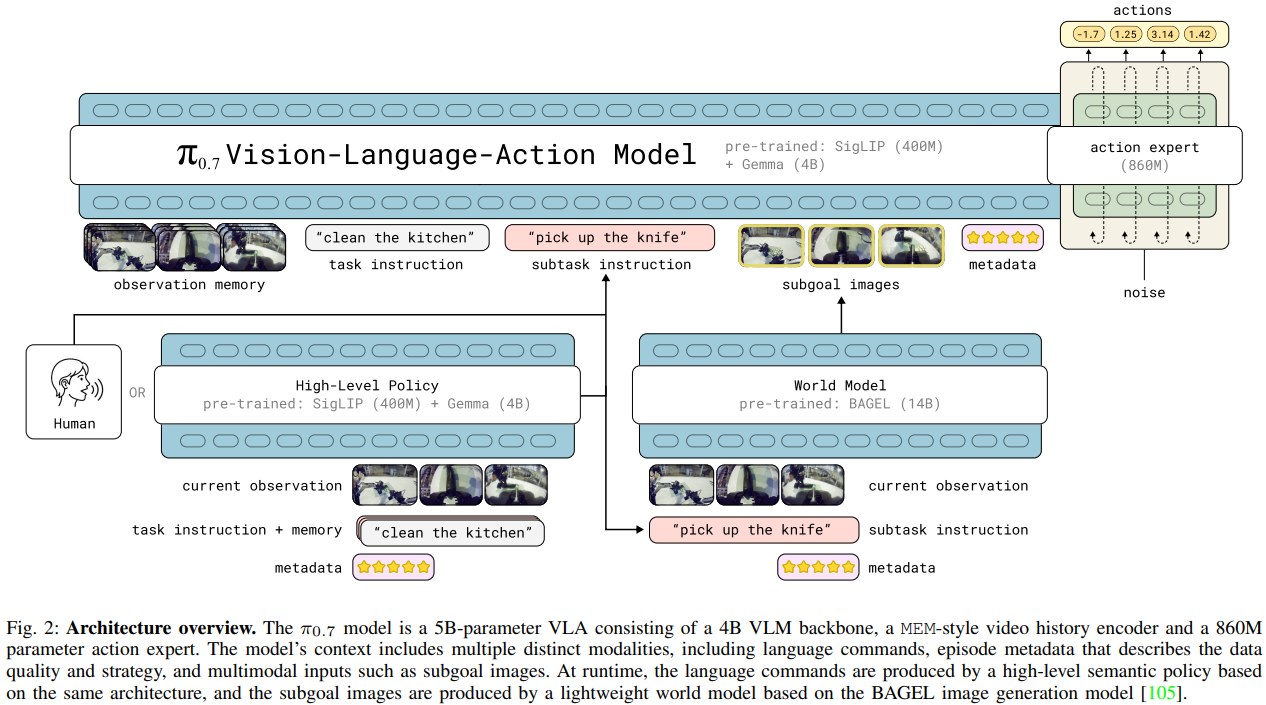
3. 最终效果
- **复杂任务开箱即用:**单个通用模型在咖啡机操作、折衣、搭纸箱等任务上接近任务专用的强化学习或监督微调模型,并在部分折衣和搭箱任务上获得更高吞吐量
- **语言泛化更强:**能在未见厨房和卧室中完成多步指令,理解用途、大小和空间关系等复杂指代,也更能执行与训练数据习惯相反的命令;视觉子目标会进一步提升表现
- **跨机器人迁移:**在没有目标机器人折衣训练数据的情况下,将折衣技能迁移到双臂 UR5e;成功率为 80%,经验丰富的人类遥操作员首次尝试为 80.6%
- **组合式泛化:**能够直接完成擦耳机、转动风扇、向电饭煲舀米等未专门采集数据的短任务;复杂长任务则可通过逐步语言指导完成,并用指导记录训练成自主高层策略
- **能够利用低质量数据:**没有质量元数据时,加入更多次优数据可能使性能下降;加入元数据后,模型能随着混合质量数据增加而持续改善
结论
这篇论文最重要的贡献并不是一种全新机器人网络结构,而是一套利用异构数据的训练方法:
不要删除所有失败和不同策略的数据,而要准确标注它们的行为属性,让模型学习完整的行为分布,并在运行时通过提示选择需要的高质量模式。
它显著提高了通用机器人在复杂操作、语言遵循、跨机器人迁移和技能组合方面的能力,但尚未达到完全通用:已见任务成功率通常超过 90%,未见任务或未见任务—机器人组合约为 60%–80%,而且很难严格确认所谓新任务是否完全没有相关训练经验