论文笔记 · 2026/07/16
OpenVLA
OpenVLA: An Open-Source Vision-Language-Action Model
https://arxiv.org/pdf/2406.09246
图像分别经过 DINOv2 和 SigLIP,特征拼接后由 MLP 投影到 Llama 的嵌入空间,并与语言指令共同作为输入 Llama 使用同一组 256 个动作 token,按固定顺序生成七个动作分量;各维度的含义由其在序列中的位置决定 生成的 token 随后被反量化为连续控制值并发送给机器人 机器人执行动作、获取下一帧图像,然后重复这一过程,形成闭环控制 基础模型主要依赖当前单帧图像,因此缺乏显式时间历史;模型推理延迟也会直接影响实际控制频率
设计
OpenVLA 基于 Prismatic-7B,结构为如下图
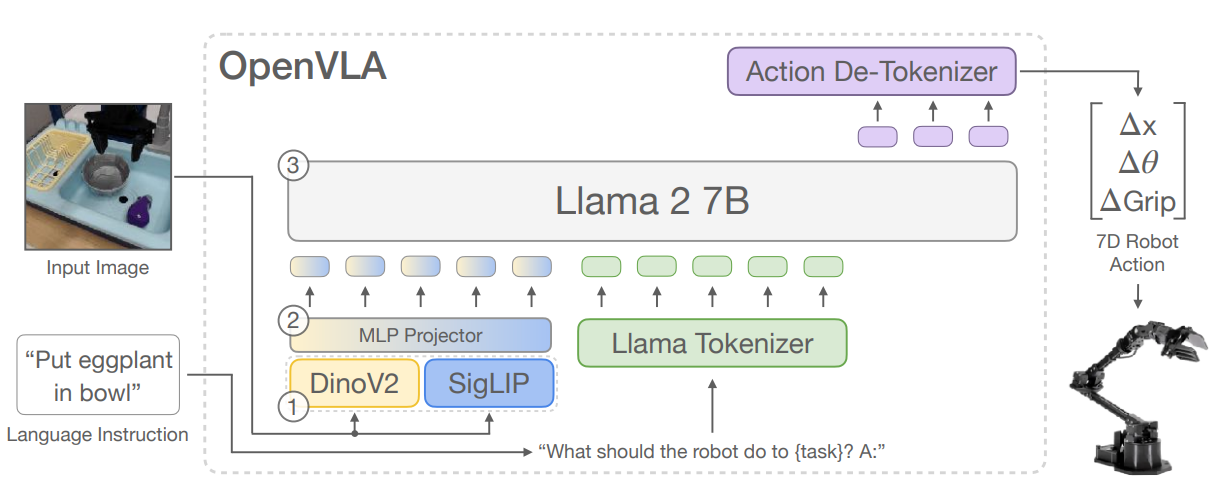
DINOv2 提供空间、局部结构
SigLIP 提供物体、语义特征
OpenVLA 输出一个七维动作:
前三维是末端执行器平移,接下来三维是旋转,最后一维是夹爪状态。
每个动作维度被独立离散为 256 个区间。区间范围不是采用训练数据的最小值和最大值,而是采用第 1 百分位至第 99 百分位,以免少数异常动作扩大范围、降低正常区域的量化精度。 把 Llama tokenizer 中使用频率最低的 256 个 token 替换成动作 token。训练目标仍然是标准的 next-token prediction,但损失只计算在动作 token 上。可以把其目标近似写成:
其中:
- 是当前图像;
- 是语言指令;
- 是第 j 个离散动作 token
这一设计的优点
它极其简单:不需要新设计动作预测头,也不需要改变语言模型训练框架。动作预测直接变成“生成一个特殊句子”。
代价
七个动作分量是自回归生成的,会增加延迟;连续动作经过离散化,也可能损失精细度。对于需要非常平滑、快速控制的任务,这会成为明显限制。
实验结论
数据多样性非常重要
数据清洗可能比复杂的模型改进更有效
视觉编码器需要微调
VLM/VLA 的优势主要体现在语言 grounding 和 OOD 泛化
OpenVLA 更擅长语言条件和语义泛化
单步、逐维自回归动作生成不是高频控制的理想终态
更高图像分辨率不一定带来更好的机器人性能
LoRA 是一个很强的 VLA 下游适配基线
只微调输出层通常不足以适配新机器人
推理延迟
表面上看:
- bfloat16 成功率约 71.3%;
- 8-bit 约 58.1%;
- 4-bit 约 71.9%。
容易得出“8-bit 量化损害模型精度”的结论。但离线动作 token 准确率相近,真正问题是 8-bit 在评测 GPU 上只能达到约 1.2Hz,而训练数据来自 5Hz 控制系统;4-bit 能达到约 3Hz,更接近训练时的动力学,因此机器人表现更好。
单帧视觉输入不足以处理时间信息