论文笔记 · 2026/07/24
World Action Models are Zero-shot Policies
World Action Models are Zero-shot Policies
https://arxiv.org/abs/2602.15922
World Action Models are Zero-shot Policies
一句话概括
论文提出 DreamZero:一个以预训练视频扩散模型为基础的 WAM。它不是直接从当前观测预测机器人动作,而是联合生成未来视频与对应动作,相当于先在视觉空间中“想象任务如何完成”,再输出能够实现该视觉未来的机器人控制指令
1. 论文解决了什么问题
现有 Vision-Language-Action 模型主要由静态图文预训练的视觉语言模型初始化,因此擅长理解“要操作什么”,但缺少对物体运动、空间变化和接触动力学的建模。结果是:它们可以泛化到新物体或新语言表达,却难以执行机器人训练数据中没有出现过的新动作,例如解鞋带、熨烫或使用新工具。
论文希望解决三个问题:
- 如何从多样、长尾且缺少重复示范的机器人数据中学习;
- 如何泛化到训练中未出现的新动作和新环境;
- 如何利用人类或其他机器人的无动作标签视频,并将大型视频模型部署为实时闭环策略
2. 使用什么方法解决
DreamZero 将机器人策略建模为未来视频和动作的联合分布:
其中 是历史视觉观测,(c) 是语言指令,(q) 是机器人本体状态。
这一过程可以概念性地分解为:
即:视频预测充当隐式视觉规划器,动作预测充当隐式逆动力学模型。
但实现上并不是两个串联模型,而是使用一个共享模型端到端联合生成视频和动作,以加强两种模态之间的对齐
3. 具体技术设计
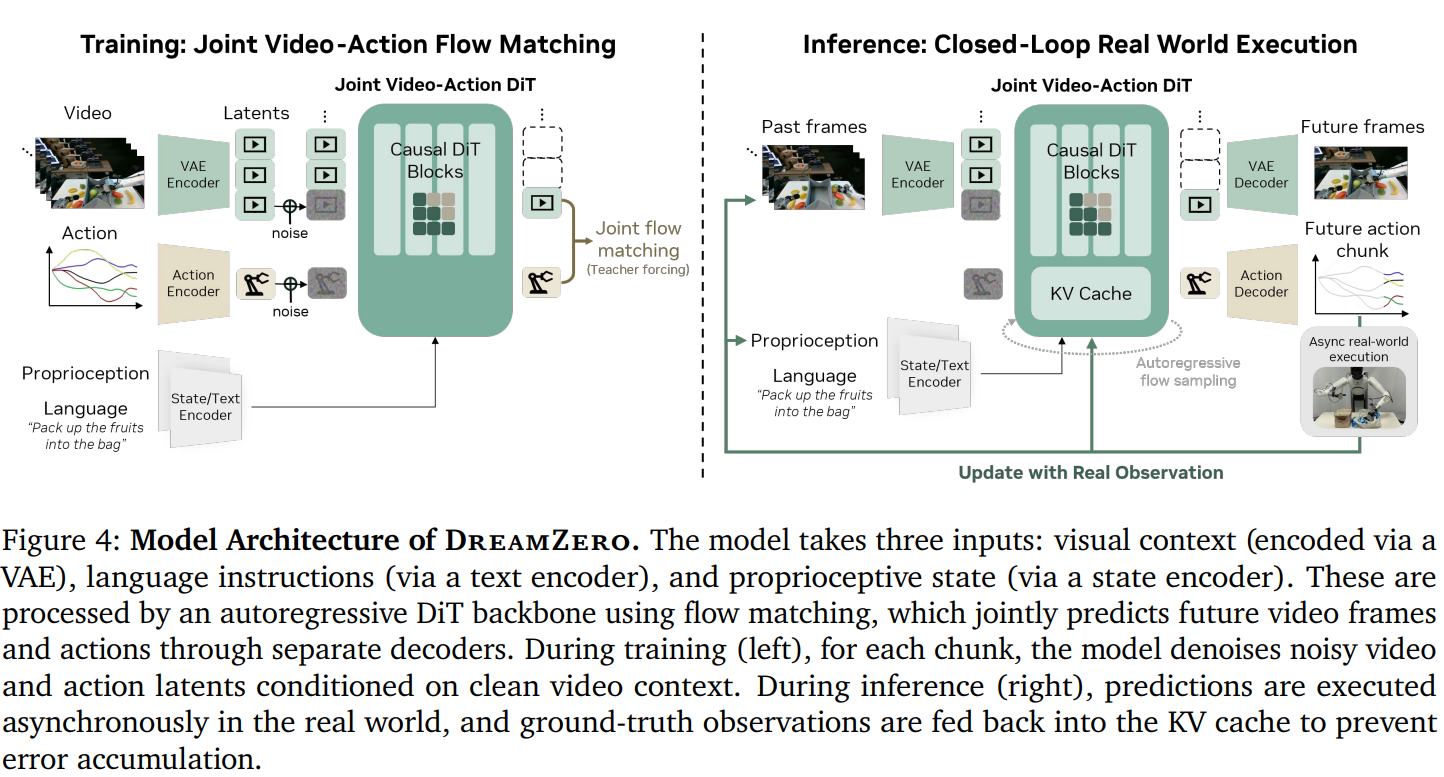
模型结构
DreamZero 使用 Wan2.1-I2V-14B 视频扩散模型作为骨干,输入包括:
- 历史相机图像,由 VAE 编码;
- 语言指令,由文本编码器编码;
- 机器人关节等本体状态,由状态编码器编码。
这些信息进入自回归 Diffusion Transformer,模型通过视频解码器和动作解码器,联合输出未来视频块和动作块。为尽量保留视频模型原有的泛化能力,新增模块主要只有状态编码器、动作编码器和动作解码器
训练方式
模型采用 Flow Matching 目标,同时对带噪的视频潜变量和动作进行去噪。训练使用 chunk-wise teacher forcing:预测当前视频—动作块时,模型能够读取之前真实、干净的视频上下文,从而学习连续的视觉变化和动作对应关系
自回归闭环推理
模型以固定长度的 chunk 自回归生成未来视频和动作,并使用 KV Cache 保存历史信息。机器人执行动作后,系统不会继续依赖先前生成的视频,而是将摄像头得到的真实观测写回 KV Cache,替换预测画面:
这一设计既利用了自回归模型的缓存效率,又避免视频预测误差持续累积
实时化设计
原始 14B 视频扩散模型推理一次约需 5.7 秒。论文结合:
- 动作执行与下一动作块生成异步并行;
- 双 GPU 并行计算 classifier-free guidance;
- DiT 中间结果缓存;
torch.compile、CUDA Graph 和算子融合;- NVFP4、FP8 和 FP16 混合量化;
- 动作序列平滑。
此外,作者提出 DreamZero-Flash,将视频和动作的扩散噪声时间步解耦:训练时让模型经常在视频仍然高度含噪的情况下预测较干净的动作,从而支持单步动作去噪。最终推理延迟从约 5.7 秒降低到约 150 毫秒,实现约 7Hz 的动作块生成
4. 主要创新点
第一,将视频世界模型直接转化为机器人策略。
视频预测不再只是辅助训练目标,而是作为隐式规划过程,与动作生成共同决定机器人行为。
第二,使用单一扩散 Transformer 端到端联合生成视频和动作。
相比“先生成视频、再由另一个模型提取动作”的方案,这种设计能够获得更紧密的视频—动作对齐。
第三,提出适合闭环机器人的自回归机制。
利用 KV Cache 提高速度,同时用真实观测替换预测帧,解决普通自回归视频生成中的误差累积问题。
第四,支持无动作标签的跨本体学习。
其他机器人或人类的视频只需要提供“任务应如何在视觉上发展”,目标机器人再利用自身学到的逆动力学将视觉过程转换为动作。
第五,使 14B 视频扩散模型达到实时控制速度。
DreamZero-Flash 与系统级优化共同证明,大型视频生成模型可以被工程化为真实机器人的闭环策略
需要注意的是,联合视频—动作建模本身并非这篇论文首次提出;其主要贡献在于将大规模视频骨干、自回归闭环设计、多样数据训练、跨本体迁移和实时优化整合为一个可在真实机器人上运行的系统。
5. 核心结果
DreamZero 在真实机器人新任务和新环境测试中的平均任务进度超过强 VLA 基线两倍;加入约 10–20 分钟其他机器人或人类的视频后,未见任务表现相对提升超过 42%;使用约 30 分钟新机器人 play data,可以完成新本体适配并保留一定的零样本泛化能力
最终结论
这篇论文的核心思想可以压缩为:
DreamZero 表明,相比只从静态图文模型继承语义知识,机器人策略还可以从视频模型中继承时空变化和物理运动先验,从而提高对新动作、新环境和新机器人本体的泛化能力。