论文笔记 · 2026/07/21
DreamDojo
DreamDojo: A Generalist Robot World Model from Large-Scale Human Videos
https://arxiv.org/pdf/2602.06949
DreamDojo: A Generalist Robot World Model from Large-Scale Human Videos
1. 解决了什么问题
机器人世界模型需要根据当前画面和机器人动作预测未来,但面临三个核心困难:
- 高质量机器人轨迹昂贵、规模有限,难以覆盖开放世界中的物体、场景和操作;
- 大量人类视频虽然包含丰富交互,却没有机器人动作标签;
- 专家机器人数据以成功轨迹为主,模型容易学习“常见剧情”,而不是真正理解不同动作导致的不同结果,尤其缺乏对反事实或失败动作的建模。
2. 解决方法
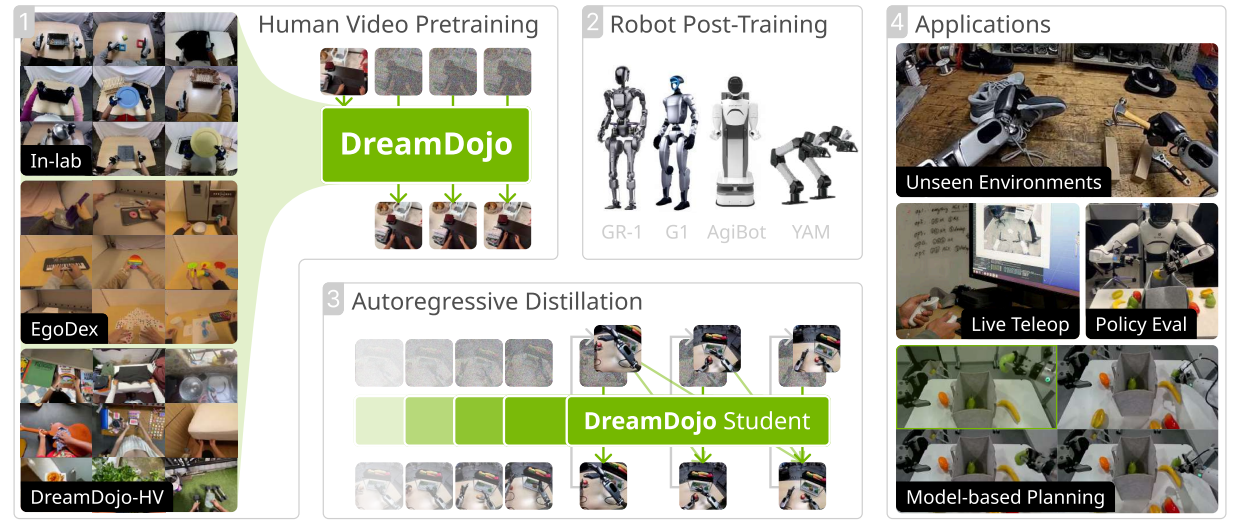
DreamDojo 采用“人类视频预训练 → 机器人数据适配 → 实时蒸馏”三阶段方案。
第一阶段:从大规模人类视频学习通用交互规律
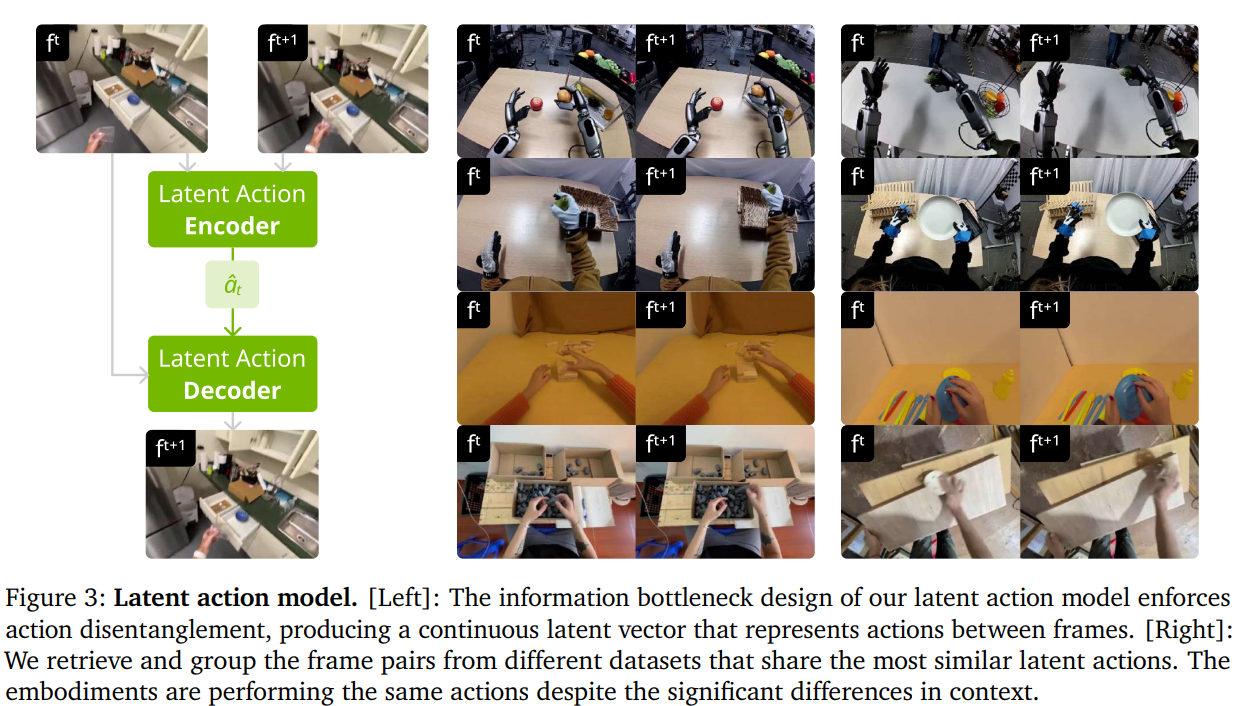
作者收集约 4.47 万小时第一视角人类视频,训练潜动作模型,从相邻视频帧中提取一个低维连续变量,作为没有真实动作标签时的“代理动作”。
世界模型由此学习:
第二阶段:适配具体机器人
使用少量目标机器人轨迹,将潜动作输入层替换为真实机器人动作输入,并对模型进行后训练,使其能够预测:
模型还采用:
- 相对动作表示;
- 与视频潜帧时间对齐的动作分块注入;
- 强化帧间运动一致性的时间损失。
第三阶段:实时化
通过因果、自回归和少步扩散蒸馏,将原本计算昂贵的视频模型转化为能够连续生成长视频的实时模型。
3. 达成的效果
- 潜动作预训练明显优于不使用动作的人类视频预训练,并接近使用专用动作捕捉设备获得真实动作标签的效果。
- 在未见物体、未见场景和反事实动作上,DreamDojo 的动作跟随和物理合理性优于未经过人类视频预训练的基础模型。
- 14B 模型在人类评测中,相比基础模型获得约 73% 的物理正确性偏好和约 73% 的动作跟随偏好。
- 蒸馏模型达到 10.81 FPS,能够进行超过一分钟的实时自回归生成。
- 在机器人策略评估中,模拟成功率与真实策略表现的 Pearson 相关系数达到 0.995。
- 用于测试时规划时,通过模拟多个候选动作并选择最佳结果,可明显提高真实机器人任务成功率。
4. 主要创新点
利用大规模人类视频训练机器人世界模型
将低成本、高多样性的人类第一视角视频作为机器人交互知识的重要来源
连续潜动作表示
从视频帧变化中自动提取动作,不依赖每个数据集特定的手部姿态、骨架或机器人动作标注系统
动作与视频潜变量的时间对齐
将动作按视频压缩比例分块,并只注入对应时间段,减少模型利用未来动作预测当前画面的因果混淆
从通用物理知识到具体机器人动作空间的适配
将“世界如何响应交互”与“具体机器人动作向量如何定义”部分解耦
面向实时交互的自回归蒸馏
把固定长度、多步去噪的视频模型转化为少步、因果、长序列模型
5. 核心贡献
DreamDojo 证明了一条可扩展的机器人世界模型路线:
先用海量人类视频和潜动作学习通用的物体交互与近似物理规律,再用较少机器人数据完成动作接口适配,最终将模型用于策略评估、动作规划和实时虚拟交互