论文笔记 · 2026/07/20
Cosmos-Predict2.5/Cosmos-Transfer2.5
World Simulation with Video Foundation Models for Physical AI
World Simulation with Video Foundation Models for Physical AI
https://arxiv.org/abs/2511.00062
1. 解决了什么问题
机器人和自动驾驶系统需要大量真实世界数据进行训练与测试,但真实数据采集成本高、覆盖有限,并可能带来设备损坏和安全风险。现有视频生成模型虽然能够生成逼真画面,但在物理场景理解、长时间一致性、动作控制、多视角同步以及下游机器人应用方面仍存在不足。
本文提出 Cosmos-Predict2.5 和 Cosmos-Transfer2.5,目标是将视频基础模型发展为面向 Physical AI 的视觉世界模拟器,用于生成训练数据、预测动作结果、评估机器人策略,并构建自动驾驶和机器人仿真环境
2. Data:训练数据如何构建
作者认为,高质量世界模型不仅依赖模型规模,更依赖真实、连续且符合物理世界分布的视频数据。
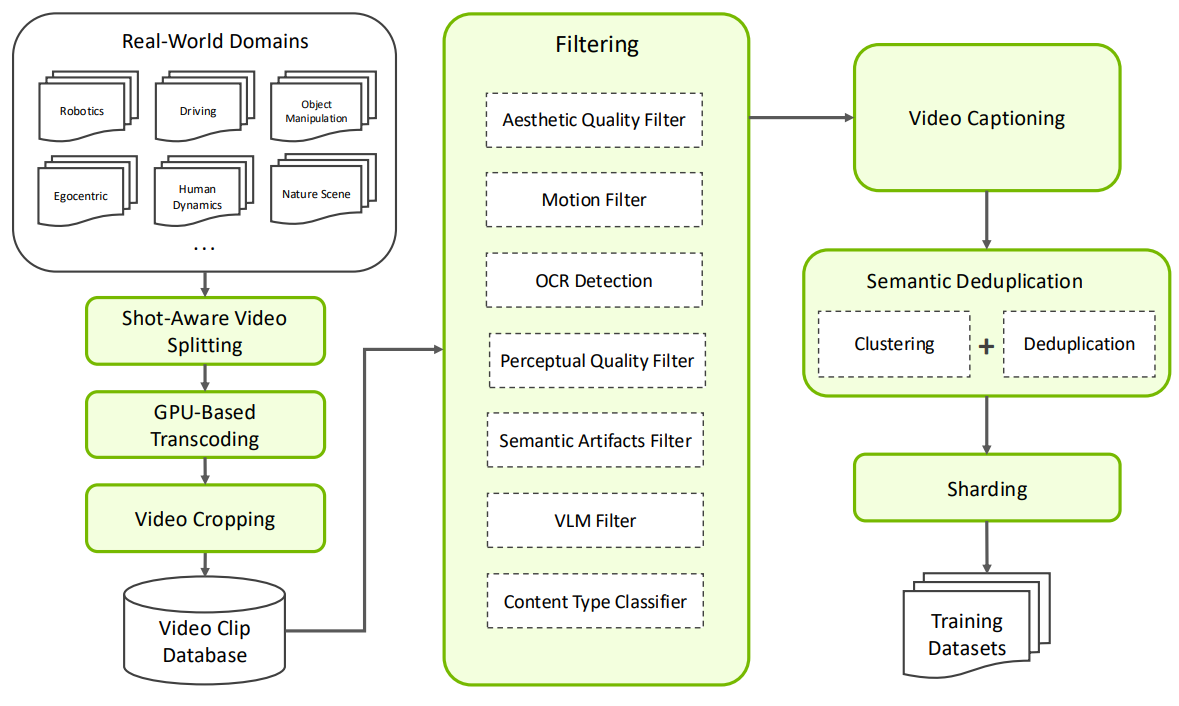
2.1 通用视频数据清洗
数据流水线处理了约 3500 万小时原始视频,切分得到超过 60 亿个视频片段,经过严格过滤后仅保留约 2 亿个高质量片段,最终保留率约为 4%。
主要处理步骤包括:
- 按镜头边界切分视频;
- GPU 转码与画面裁剪;
- 过滤低画质、低运动量、字幕覆盖、失真和异常转场;
- 使用视觉语言模型去除动画、游戏和不符合真实物理分布的内容;
- 为视频生成不同详细程度的文本描述;
- 基于语义相似度去重;
- 按内容类型、分辨率、宽高比和时长进行数据分片。
这种严格清洗减少了镜头跳变、静态画面、文字覆盖和伪物理现象对模型训练的干扰。
2.2 Physical AI 专项数据
除通用视频外,作者进一步构建了五类领域数据:
- Robotics:机械臂、双臂机器人和人形机器人操作数据;
- Autonomous Driving:道路、车辆、行人、交通信号和多摄像头驾驶数据;
- Smart Spaces:工厂、仓库、施工场所等工业环境;
- Human Dynamics:人体运动、姿态和人与环境交互;
- Physics:碰撞、滚动、破碎、液体流动和重力等可见物理现象。
不同领域使用专门的过滤条件和文本描述模板。例如,机器人数据会详细描述机械臂、手腕、夹爪和物体的运动顺序;驾驶数据则重点描述自车运动、交通参与者和道路状态。
这部分数据的作用是使模型不仅学习一般的视频外观,还能学习与机器人、驾驶和物理交互相关的时序规律。
3. 解决方法
3.1 Cosmos-Predict2.5
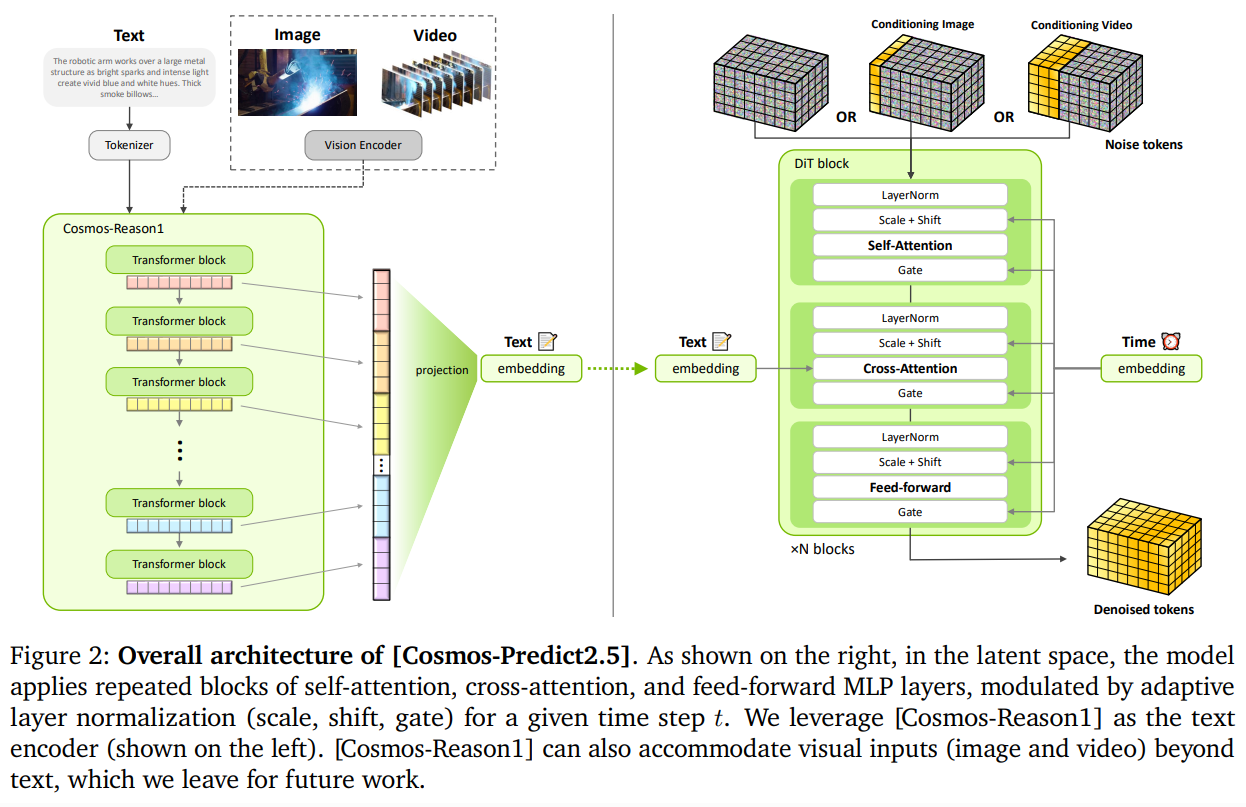
Cosmos-Predict2.5 是一个基于潜空间 DiT 的视频世界模型,统一支持:
- Text2World:由文本生成世界视频;
- Image2World:由图像预测后续视频;
- Video2World:续写或转换已有视频。
模型从上一代的 EDM 参数化切换为 Flow Matching,直接预测数据与噪声之间路径的运动速度:
这种速度预测目标更直接,并有利于平滑优化和提升生成质量。
模型使用 WAN2.1 VAE 压缩视频,使用 3D RoPE 表示时空位置,并使用面向 Physical AI 的 Cosmos-Reason1 替代普通 T5 文本编码器,以增强对机器人动作、物理过程和复杂场景描述的理解。
训练过程包括:
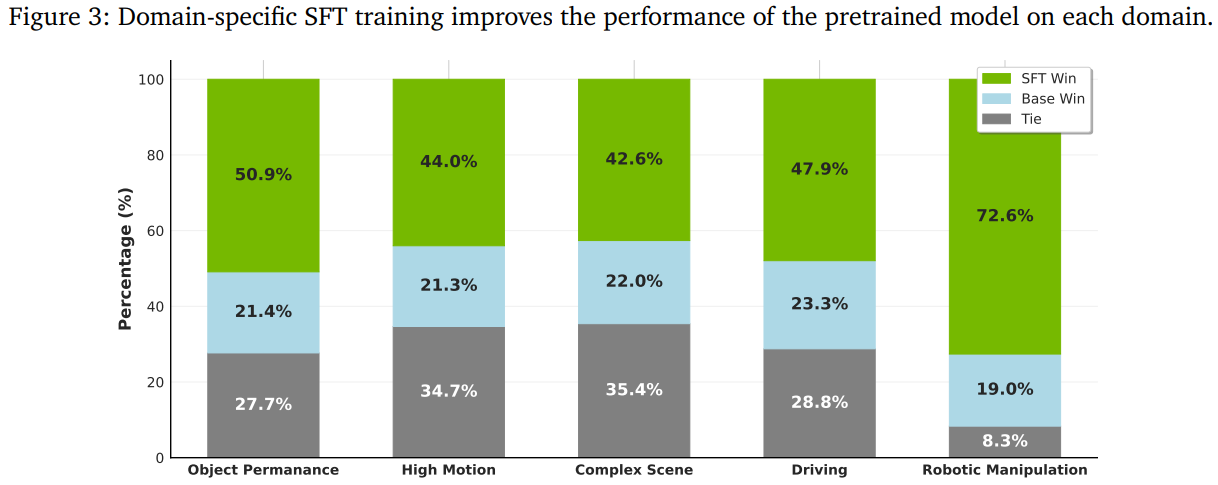
领域专家分别学习机器人、驾驶、高速运动、复杂场景等能力,之后通过模型合并形成统一模型。强化学习根据文本对齐、运动合理性和视觉质量优化生成结果,蒸馏则将推理压缩到少量生成步骤。
3.2 Cosmos-Transfer2.5
Cosmos-Transfer2.5 在 Predict2.5 基础上增加类似 ControlNet 的控制分支,可接收:
- 深度图;
- 边缘图;
- 语义分割图;
- 模糊视频;
- 道路和场景结构地图。
模型利用这些条件保持场景的空间结构,同时重新生成逼真的外观,可用于 Sim2Real、Real2Real、机器人数据增强和自动驾驶多视角模拟。
4. 效果如何
在 PAI-Bench 上,后训练模型取得:
- Text2World Overall Score:0.768;
- Image2World Overall Score:0.810。
2B 模型已经能够接近参数量更大的视频模型;14B 模型在人类评价中表现更明显,相比 Wan2.1-14B 获得 48.6% 对 31.8% 的偏好优势。
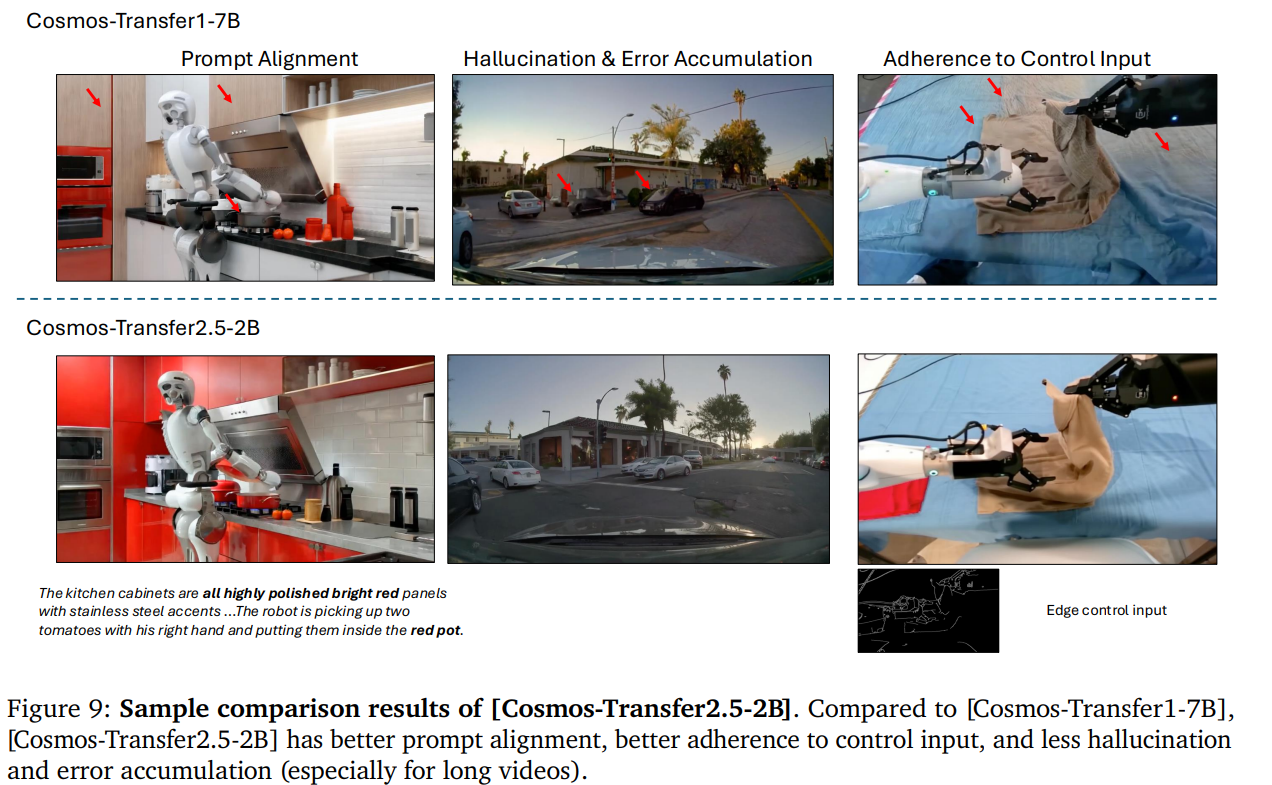
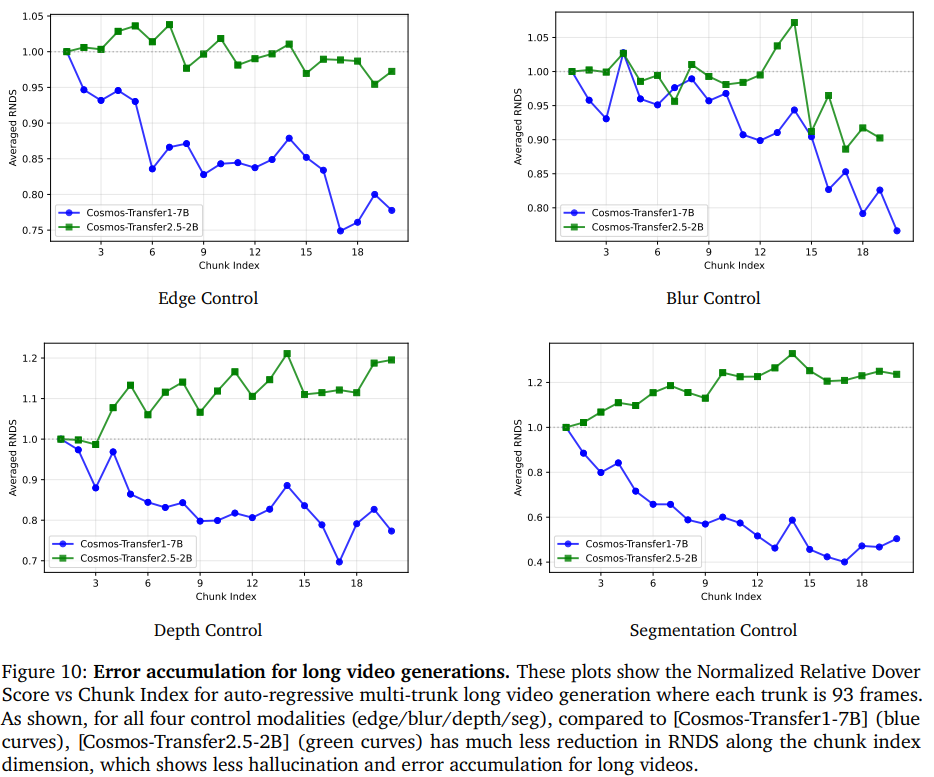
Cosmos-Transfer2.5 的参数量仅为上一代约 (1/3.5),但在控制条件对齐、视频质量和长视频稳定性方面均优于 Cosmos-Transfer1
在真实机器人实验中:
- 仅使用原始数据训练:成功 1/30;
- 使用普通图像增强:成功 5/30;
- 使用 Transfer2.5 生成语义级视频增强数据:成功 24/30。
这表明改变物体类别、颜色、材质、光照和背景的语义级视频增强,可以显著提高机器人策略面对未知视觉环境时的泛化能力。
在动作条件视频预测任务中,Predict2.5-2B 相比上一代 7B 模型将 PSNR 从 21.14 提升至 24.95,FVD 从 190 降至 146,说明其能够更准确地根据机器人动作预测未来视觉状态。
5. 主要创新点和价值
本文的主要创新包括:
- 构建了规模更大、过滤更严格且包含 Physical AI 专项数据的视频训练体系;
- 使用 Flow Matching,并在单一模型中统一三种世界生成任务;
- 使用 Cosmos-Reason1 提升模型对物理场景和复杂动作指令的理解;
- 将领域微调、模型合并、强化学习和少步蒸馏整合为完整后训练流程;
- 通过 Transfer2.5 实现深度、分割、边缘、地图和多视角相机等结构化控制;
- 不仅评价视频质量,还验证了模型对真实机器人策略学习、自动驾驶模拟、VLA 数据生成和动作结果预测的实际价值。
本文最重要的价值在于,它将视频生成模型从视觉内容生成工具扩展为 Physical AI 的数据生成层和视觉模拟层。模型可以在机器人进入真实环境之前,生成多样化训练数据、预测动作结果并测试策略的视觉泛化能力,从而降低真实数据采集和实验部署的成本与风险。
其本质仍然是一个可控制的视觉世界近似模型,而不是严格满足物理定律的传统物理仿真器;但论文证明了高质量视频基础模型已经可以为机器人和自动驾驶系统提供具有实际价值的训练与评估环境。