论文笔记 · 2026/07/22
Cosmos Policy
Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning
https://arxiv.org/abs/2601.16163
Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning
1. 概括
Cosmos Policy 将预训练视频生成模型直接微调为机器人策略,让同一个模型同时生成机器人动作、预测动作后果,并判断未来状态的好坏。
它的核心思想是:
2. 论文解决了什么问题?
预训练视频模型能够从大量视频中学习:
- 物体如何运动;
- 接触后会发生什么;
- 场景如何随时间变化;
- 一种当前状态可能对应哪些不同未来。
这些时空知识很适合机器人控制。
但此前将视频模型用于机器人时,通常需要多个阶段:
这类方法存在三个问题:
- 需要额外的动作编码器、动作头或逆动力学模型;
- 训练过程复杂,视频预测误差还会传递到动作预测;
- 策略、世界模型和价值函数通常是彼此独立的网络。
Cosmos Policy 要解决的核心问题是:能否不修改视频模型结构,直接把一个预训练视频模型变成可执行动作的机器人策略?
本文的思路是:只需要重新组织视频模型潜变量序列中的内容,并在机器人演示数据上进行一次后训练。
3. 核心方法:潜帧注入
视频生成模型不会直接处理原始图片,而是先用 VAE 将图片压缩成潜变量:
其中 可以理解为一张图片的“数字压缩包”,论文称其为潜帧。
原始视频模型处理的序列类似:
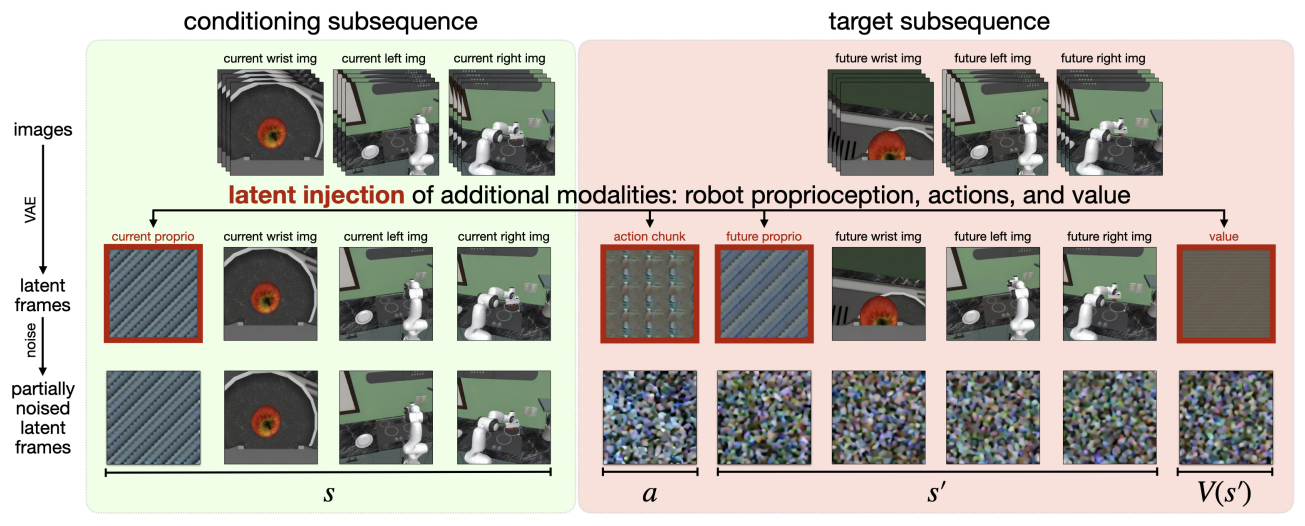
Cosmos Policy 将动作、机器人状态和价值也整理成与潜帧相同的张量形状,然后插入这个序列:
其中:
- ():当前关节角、末端位姿等机器人状态;
- ():当前多视角相机图像;
- ():接下来 (K) 步的动作序列;
- :执行动作后的未来状态;
- :该未来状态的预期累计奖励。
动作和价值并没有真的变成图片,只是被复制、归一化并排列成与视频潜帧相同的尺寸。
例如,低维动作向量经过归一化和重复填充后得到:
这样,原视频 Transformer 不需要增加新的输入接口或输出头,就能处理动作、状态和价值。模型通过它们在序列中的固定位置,逐渐学会每个潜帧代表什么。
4. 一个模型承担三个功能
Cosmos Policy 使用同一个扩散 Transformer,同时学习三个条件分布。
4.1 机器人策略
根据当前状态生成动作块:
其中 (c) 是语言任务描述,例如“把红色积木放进盒子”。
模型不是回归唯一动作,而是学习动作分布,因此可以表示多种正确操作方式。
4.2 世界模型
给定当前状态和候选动作,预测动作执行后的状态:
这里的“状态”主要包括未来机器人本体状态和未来相机图像。
它回答的问题是:执行这个动作之后,可能会发生什么?
4.3 价值函数
预测未来状态最终完成任务的可能性或预期累计奖励:
它回答的问题是:这个未来状态好不好?从这里继续操作,成功希望有多大?
三个功能共用同一个网络,区别主要在于训练时哪些潜帧保持干净作为条件,哪些潜帧被加噪并要求模型恢复。
5. 统一训练目标
Cosmos Policy 沿用视频扩散模型原来的去噪目标。
设完整多模态潜变量序列为 (Z),加入高斯噪声:
模型学习恢复干净序列:
通过改变条件掩码,同一个去噪任务可以变成:
或:
或:
因此,作者不需要分别设计策略损失、视频预测网络和价值网络。
6. 为什么还要同时预测未来状态?
策略训练时,模型不只预测动作,还辅助预测:
这会迫使模型理解:
- 当前物体在哪里;
- 动作将产生什么后果;
- 后果是否符合任务目标。
如果只训练
模型可能只记住表面的动作相关性。
加入未来状态预测后,模型还必须学习:
即“为什么要执行这个动作,以及动作会造成什么变化”。
消融实验中,仅预测动作的版本在 RoboCasa 上从完整模型的 (67.1%) 降至 (44.4%),说明未来状态监督不仅用于规划,也显著提升了直接策略。
7. 基于模型的规划
直接策略可以从动作分布中采样多个候选动作:
随后对每个候选动作进行一次短期“想象”:
再预测这些未来状态的价值:
最终执行价值最高的动作:
整个过程可以概括为:
这种方法属于 best-of-(N) 一步规划,而不是长时间、多层级的搜索。
【原文图片占位:规划流程图——展示 Policy Model 生成多个动作,Planning Model 预测未来状态和价值,最后选择最高价值动作。】
8. 为什么需要策略 rollout 数据?
专家演示大多是成功轨迹,因此世界模型可能只见过“正确动作会产生什么结果”,却不熟悉:
- 抓取落空;
- 夹爪打滑;
- 拉链没有打开;
- 机械臂遮挡目标;
- 动作偏离专家分布。
为了让模型能够评价错误动作,作者部署基础策略,收集真实执行产生的成功和失败轨迹,再重点微调世界模型与价值函数。
可以理解为:
规划时保留原始模型负责提出动作,使用 rollout 微调后的模型负责预测动作后果和评分。
9. 主要创新点
创新一:不修改架构地生成机器人动作
动作被编码成视频潜帧,直接使用视频扩散模型的原生生成机制,不需要增加专门的动作头或逆动力学模型。
创新二:策略、世界模型和价值函数统一
同一个模型同时表示:
三者共享视频模型的时空表示能力。
创新三:未来预测既用于辅助训练,也用于测试时规划
预测未来状态不仅能帮助筛选动作,还能约束策略理解动作后果,从而提升不使用规划时的直接控制性能。
创新四:利用视频预训练表示多模态动作
扩散模型学习的是完整动作分布:
而不是动作均值。这适合存在多种正确操作方式的任务,例如从不同方向抓取物体或选择不同物体顺序。
10. 实验结论
作为不带规划的直接策略,Cosmos Policy 达到:
- LIBERO:平均成功率 (98.5%);
- RoboCasa:平均成功率 (67.1%);
- ALOHA 双臂真机任务:平均得分 (93.6%)。
在两个困难的真机任务中加入世界模型规划后,平均任务完成率提高约 (12.5) 个百分点
11. 局限性
- 模型规模较大,完整微调和推理成本较高。
- 规划需要为多个候选动作生成未来状态并评分,速度较慢。
- 世界模型只预测一个动作块后的状态,不是长时间连续模拟。
- 模型预测的是相机和机器人传感器能够观察到的状态,无法直接获得摩擦力、接触力等隐藏信息。
- 有效规划仍需要额外收集机器人 rollout 数据。
12. 最终理解
Cosmos Policy 最重要的贡献,不只是“用视频模型控制机器人”,而是将机器人控制重新表达成一个统一的条件生成问题:
通过把动作、状态和价值统一包装成视频潜帧,作者让一个预训练视频模型同时成为:
它证明了视频模型学到的时空和物理先验,不仅可以用于“生成未来画面”,也可以直接用于“生成能够改变未来的机器人动作”。