论文笔记 · 2026/07/17
π0
π0: A Vision-Language-Action Flow Model for General Robot Control
blog: https://www.pi.website/blog/pi0
paper: https://www.pi.website/download/pi0.pdf
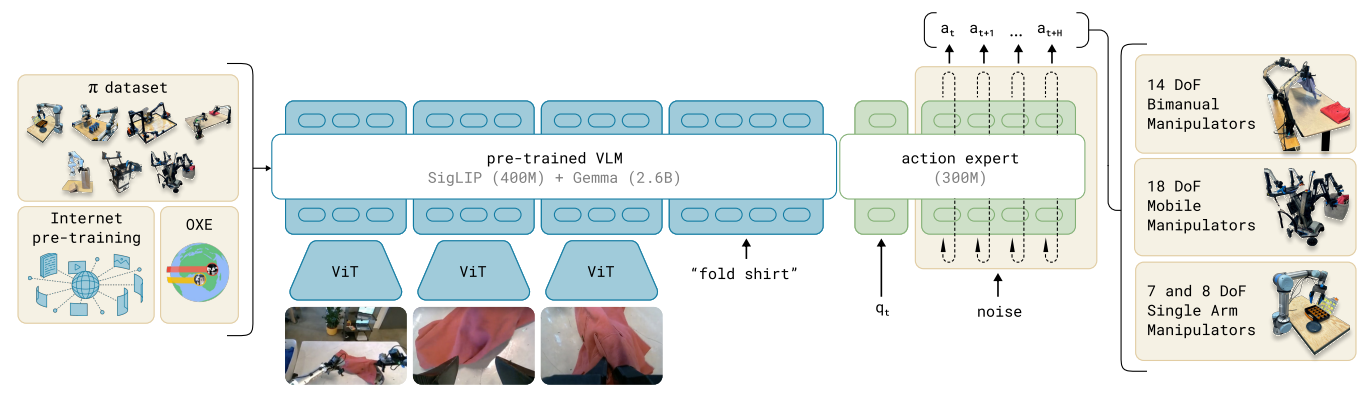
在时刻 t,模型观察为:
其中:
- :第 i 路 RGB 相机图像,每台机器人使用两到三路图像;
- :语言指令;
- :机器人本体状态,例如关节角。
模型预测长度为H 的动作块:,论文中 H=50
这意味着模型一次规划一段连贯的未来运动,而不是每个控制周期都孤立地决定一次动作。
架构
VLM 主干
处理图像和文字
它从 PaliGemma 初始化,因此已经学到大量互联网语义知识,例如物体类别、语言关系和视觉概念。
Action expert
处理:
- 机器人状态;
- 带噪声的动作序列;
- 连续动作输出。
两部分通过 Transformer 的注意力机制交换信息
Flow matching 的直觉
Flow matching 的目标不是直接从观察回归出唯一动作,而是学习一个“速度场”,把随机噪声逐渐运输成合理动作。
训练时,先取一段真实动作 AtA_tAt,再采样高斯噪声:
在噪声和真实动作之间进行插值:
- :几乎是纯噪声;
- :真实动作;
- 中间位置:部分被污染的动作。
网络学习预测应该沿哪个方向移动,才能从当前带噪动作靠近真实动作。目标向量场是:
训练损失为:
这里的 就是模型学习到的“动作流向”
推理时
实际运行时没有真实动作可以加噪,所以从纯随机动作开始:
然后反复沿网络预测的方向更新:
论文使用 10 个 Euler 积分步骤 。十步之后,随机噪声被转换成与图像、语言和机器人状态相符合的动作块。
为什么它适合机器人动作
- 连续精度。 不必把关节位置或速度量化成有限的离散编号。
- 多种合理解。 同一场景可以存在不同抓取或折叠策略,生成模型可以表示多峰分布。
- 时间一致性。 50 个动作 token 可以彼此进行双向注意力,因此整段运动可以联合生成,而不是每一步互不协调。
工程细节
图像、语言和机器人状态在十次 flow 更新期间基本不变,因此模型缓存这些 token 的注意力 key/value,只重复计算动作部分。
机器人不会执行完整 50 步后才重新观察:20 Hz 平台大约执行 16 步后重规划,50 Hz 平台大约执行 *25 步后重规划。两次重规划之间的动作则按动作块开环执行。