论文笔记 · 2026/07/18
DreamGen
DreamGen: Unlocking Generalization in Robot Learning through Video World Models
#Synthetic data generation#Video World Models
DreamGen: Unlocking Generalization in Robot Learning through Video World Models
https://arxiv.org/abs/2505.12705
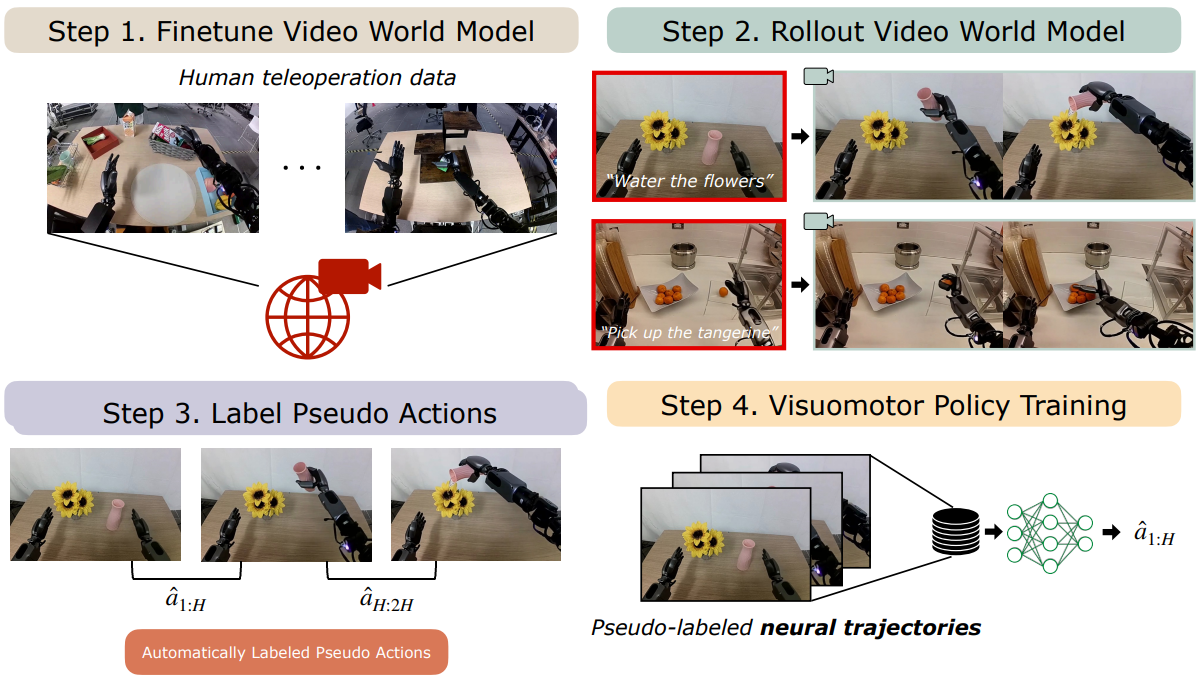
论文目标:降低机器人学习对大量人工遥操作数据的依赖。核心思想是把视频生成模型作为离线数据生成器
DreamGen 的流程包含四步:
机器人适配
使用少量真实机器人视频,通过 LoRA 微调通用视频模型,使其学习目标机器人的外观、视角和运动方式,同时尽量保留互联网视频预训练获得的物体、场景与行为知识。
生成机器人视频
输入真实环境的初始图像和语言指令,视频模型生成机器人执行任务的未来视频。由此可以合成训练数据中未出现的新任务、新物体和新环境。
补充伪动作标签
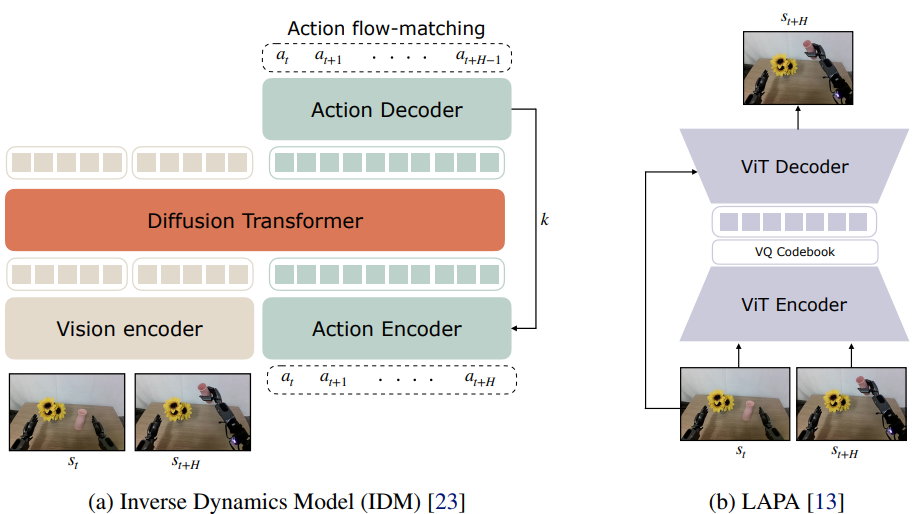
生成视频只有图像,没有机器人动作,因此作者提出两种标注方式:
- IDM:输入起始帧和未来帧,利用 SigLIP-2、视觉 Transformer 和 Diffusion Transformer,通过 flow matching 预测两帧之间的连续机器人动作序列。IDM 输出位于目标机器人的真实动作空间,但需要该机器人的动作标注数据训练。
- LAPA:输入当前帧和未来帧,通过时空编码器提取视觉变化,并利用 VQ-VAE 目标学习潜在动作表示。它不需要真实动作标签,可在机器人视频、人类视频和模拟视频上训练,但输出不是可直接执行的机器人控制量。DreamGen 实际使用量化前的连续潜在表示。
训练机器人策略
将生成图像、语言指令和伪动作组成 Neural Trajectories,再按普通模仿学习方式训练 Diffusion Policy、π0 或 GR00T N1。部署时只运行机器人策略,不需要实时运行视频模型。