论文笔记 · 2026/07/20
Cosmos-Transfer1
Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control
Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control
https://arxiv.org/pdf/2503.14492
解决的问题
模拟器能够提供准确的动作、几何、深度、分割、LiDAR 和道路地图,但生成的画面往往不够真实;普通视频生成模型虽然能生成真实画面,却容易改变物体位置、机器人动作或道路结构。
这篇论文要解决的是:在保留模拟视频关键结构和运动的前提下,改变纹理、光照、天气和环境外观,生成真实且多样的视频。
主要服务于机器人 Sim2Real 和自动驾驶数据扩增。
核心思想
论文把不同控制信号看成不同类型的约束:
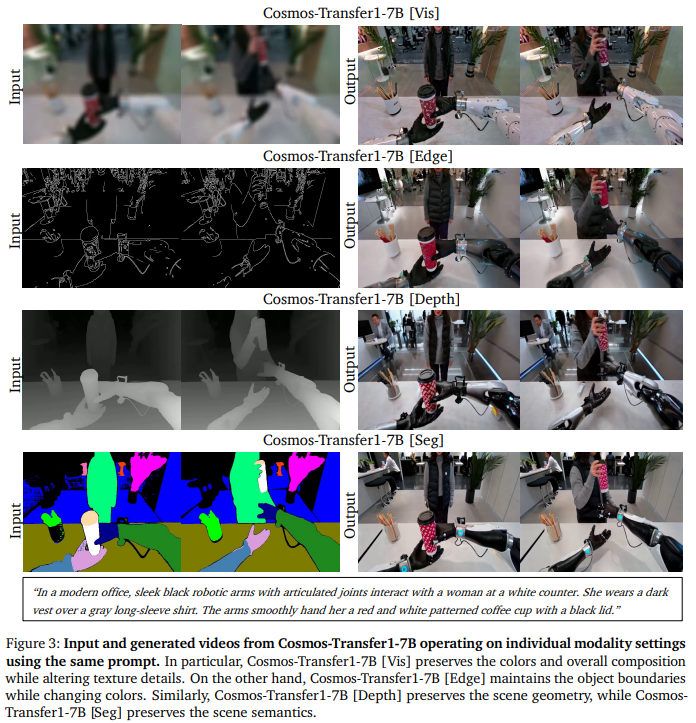
- Vis:保留颜色和整体外观;
- Edge:保留轮廓和细小结构;
- Depth:保留三维几何;
- Seg:保留物体区域和场景语义;
- LiDAR、HDMap:保留车辆、道路和三维布局。
最关键的创新是:每种条件的控制强度不是一个固定标量,而是时空变化的权重:
因此模型可以做到:
- 机器人区域重点使用 Edge,防止机械臂变形;
- 背景使用 Depth 或 Seg,允许重新生成材质和物体;
- 道路区域依赖 HDMap;
- 车辆区域依赖 LiDAR。
也就是让模型在不同时间、不同位置,听从不同的控制条件。
模型设计
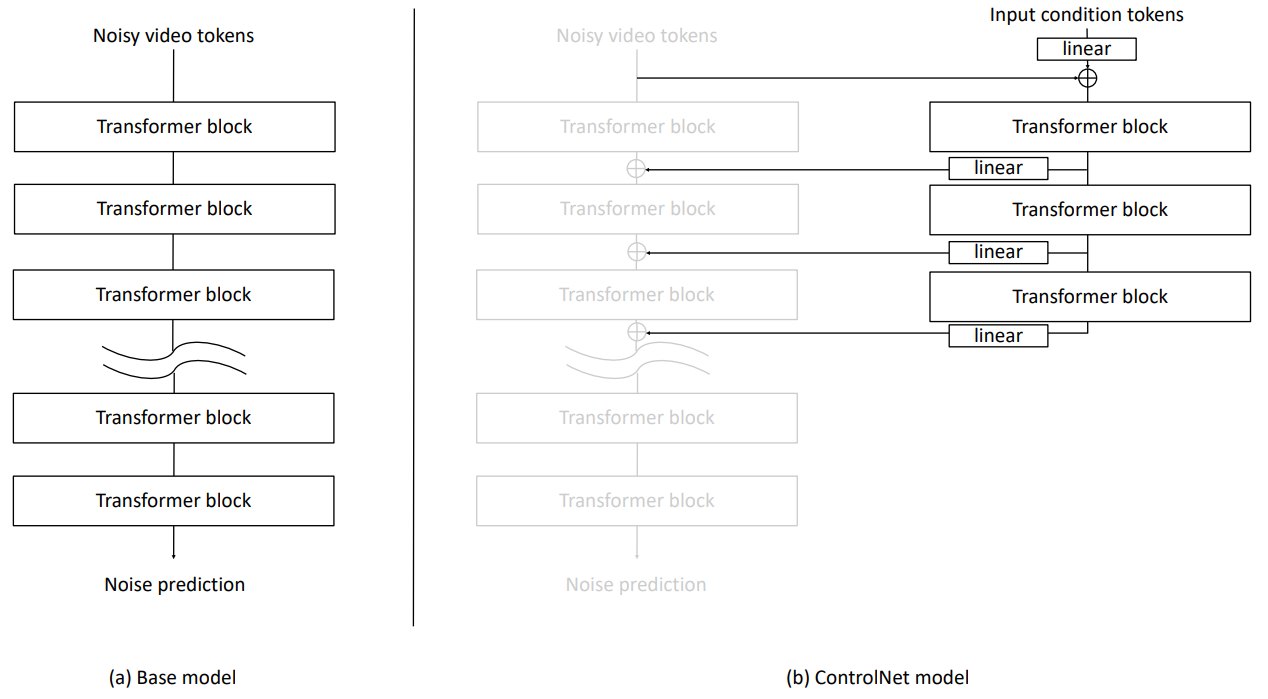
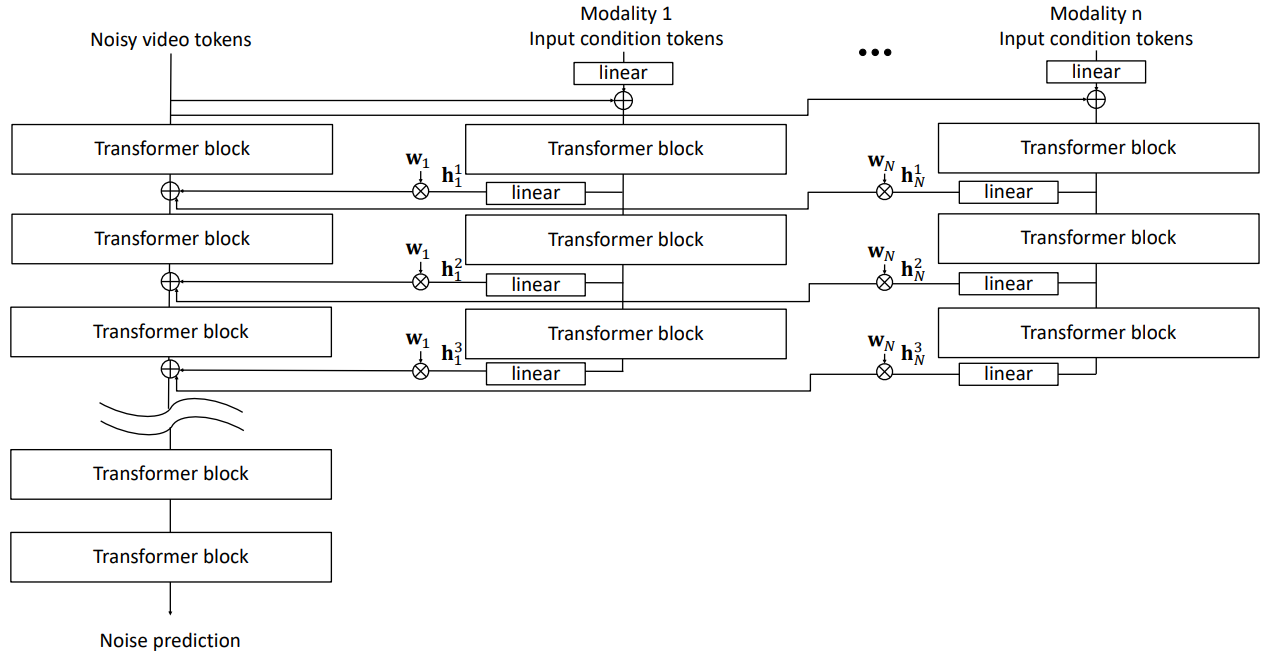
模型建立在冻结的 Cosmos-Predict1-7B 视频扩散模型之上。
每种模态单独训练一个 ControlNet 分支:
控制分支处理对应条件视频,其输出经过零初始化线性层,再注入主 DiT:
其中 是第 m 种模态产生的控制特征。
训练时:
- 冻结基础视频生成模型;
- 每次只训练一种模态的控制分支;
- 目标是预测 RGB 视频 latent 中加入的噪声,而不是直接预测 RGB 图像。
推理时:
- 输入随机噪声、文本和一种或多种控制视频;
- 根据时空权重融合多个 ControlNet;
- 多步去噪后由 VAE 解码为 RGB 视频。
这种“分别训练、推理时组合”的设计降低了训练成本,也方便增加新模态。
时空自适应多模态控制
对于 N 个控制分支,模型为每个分支配置一张时空控制权重图:
其中 表示:在第 t 帧、空间位置 (x,y) 上,模型应当多大程度地服从第 i 种控制模态。与为整个视频设置一个固定标量权重不同,这里的权重可以随时间和空间连续变化。
设第 i 个控制分支在第 j 个注入位置产生的控制特征为:
权重图 会被下采样或重排到与该层特征相同的时空分辨率,并沿特征维度 D 广播。第 j 层注入主干的控制残差可写为:
主干特征更新为:
其中:
- 是与当前特征分辨率对齐后的时空权重;
- 表示逐帧、逐空间位置相乘;
- 同一个位置可以同时融合多个模态,而不必只选择一个分支。
因此,在位置 ((t,x,y)) 上,实际加入主干的控制量是:
这相当于让模型在每一帧、每一个局部区域分别决定“此刻更应该听从哪个模态”。
例如,在机器人操作视频中,可以设置:
用于机械臂区域,以保留关节、夹爪和轮廓;而在背景区域设置:
为较高值,使模型保留场景布局和几何关系,同时允许重新生成墙面材质、灯光和物体外观。随着机器人运动,前景掩码及其控制权重也可以逐帧移动,因此控制区域能够持续跟随目标。
当某个位置上的多个权重之和大于 1 时,可以进行归一化:
从而避免多个控制分支在同一位置产生过强的叠加影响。
这一设计将传统的“全局模态权重”扩展为:
使模型能够在不同区域调用最相关的控制信号:需要严格保持轮廓时依赖 Edge,需要保持三维结构时依赖 Depth,需要保持语义区域时依赖 Seg,需要保留原始颜色和外观时依赖 Vis,从而实现细粒度、自适应的多模态视频控制。
实验效果
通用视频控制
论文在包含机器人、驾驶和第一人称视频的 TransferBench 上测试。
实验表明:
- Vis 最能保持原视频外观,但生成多样性较低;
- Edge 最能保持轮廓;
- Depth 和 Seg 给模型更多生成自由;
- 多模态融合虽然不一定在每个单项指标上最好,但整体视频质量和结构保真更加均衡。
时空局部控制
改变某一区域的模态权重,会明显改变该区域对对应条件的遵从程度。
例如增加前景 Vis 权重后,前景外观与输入更加一致;增加背景 Depth 权重后,背景几何误差下降。这证明时空权重确实能实现局部控制,而不只是简单叠加多个条件。
机器人 Sim2Real
单独使用 Seg 等稀疏条件时,机械臂容易变形。将机器人前景交给 Edge 或 Edge+Vis,背景交给 Seg 后:
- 机器人形状和动作保存得更好;
- 厨房材质、灯光和环境可以发生较大变化;
- 视频质量优于多数单模态配置。
自动驾驶
HDMap 擅长保持车道和道路结构,LiDAR 擅长保持车辆和三维几何。两者融合后:
- 获得最好的车道一致性;
- 同时保持接近 LiDAR 单模态的三维准确性;
- 可以从同一个驾驶场景生成夜晚、雨天等多种视觉版本。
结论
这篇论文的核心贡献可以概括为:把模拟器提供的深度、边缘、分割、LiDAR 等信息作为视频的结构骨架,把扩散模型作为负责真实外观的生成器,再用时空权重决定每个区域应该服从哪一种结构条件。
它解决了生成视频中“真实感”和“结构保真”难以兼得的问题,使模拟数据能够在不明显破坏动作、几何和语义的情况下,被转换成更加真实、多样的视频。
需要注意的是,论文主要证明了生成质量和条件一致性,并没有充分证明这些生成数据一定能提升真实机器人成功率或自动驾驶系统的闭环性能。