论文笔记 · 2026/07/16
MolmoAct
MolmoAct Action Reasoning Models that can Reason in Space
#VLA#Reasoning#Discrete Tokens VLA
https://arxiv.org/abs/2508.07917
现有的VLA模型采取:图像+指令→动作 这种直接映射存在两个问题:
- 不透明:难以知道机器人为什么选择某个动作;
- 脆弱:当物体、场景、语言或机器人形态变化时,模型可能失效。
因此本文在 VLA 中加入了一组具有空间含义的中间变量
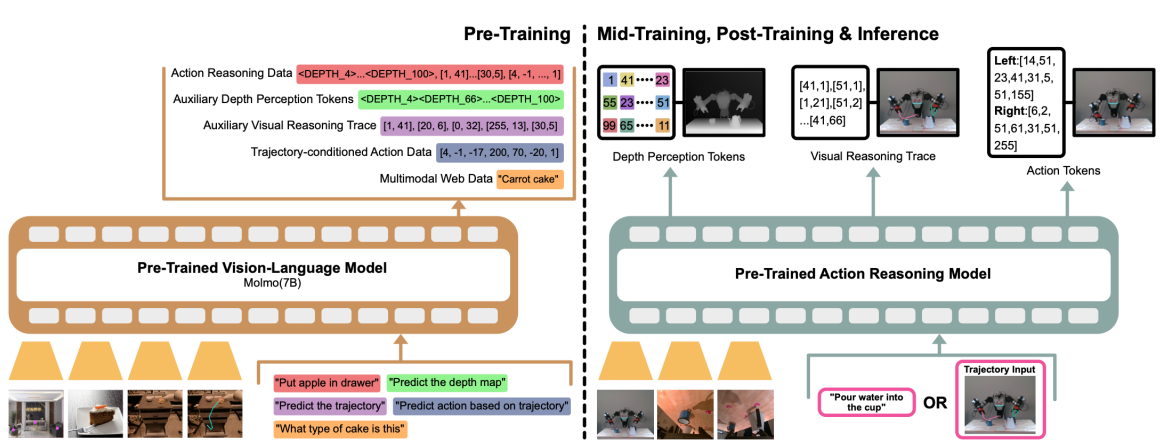
- 论文对于动作tokens的划分有一个新的技巧:
- 传统方法中词表中拿256个毫不相干的token来表示动作存在初始化上的问题:动作token本身是具有顺序的“ 应该比 更加接近 ”
- MolmoAct 取 Qwen2 常规词表末尾连续的 256 个已有 BPE token,以反向但单调的次序映射到 256 个动作编号。这样严格保留了 bin 的邻接顺序,并复用了预训练 embedding;作者认为相邻 BPE 符号的字符相似性会带来更平滑的初始化
- 依据是:这些连续的尾部 BPE 符号在字符构成上存在相似性,并报告这种初始化有助于训练,大幅度减少训练时间
- 对比传统的端到端(中间是不可解释的黑箱)的VLA范式,吸取了CoT、MCoT的思路,论文网给出一个类似”Think with Images”范式的思路,不依赖语言空间上的推理过程,而是引入空间推理
第一层:Depth Perception Tokens
先使用 Depth Anything V2 生成伪深度图,再训练一个 VQ-VAE 将深度图压缩成离散 token
深度 codebook 有 128 个编码;每幅图像使用 100 个深度 token;图像被调整到 320×320;模型只看 RGB 图像,却学习预测对应的深度 token;
得到的格式是:
专业深度模型→产生伪标签→VLA 学习预测深度 token
第二层:Visual Reasoning Trace
模型预测机械臂末端执行器未来的图像空间轨迹: 其中每一个 都是图像上的二维点
- 第一个点代表当前末端执行器位置;
- 最后一个点接近该演示轨迹的终点;
- 中间最多选择三个均匀间隔的未来位置;
- 将这些点相连,就形成一条二维折线。
轨迹标签是怎样产生的:
- 用 Molmo 做点选(prompt 类似 “point to the robot gripper”)得到夹爪 2D 点。
- 沿 episode 逐帧连成轨迹;对每个时刻取“当前点→终点”的未来子轨迹并均匀抽样,长度 1~5 点(当前点、终点、最多 3 个中间点)。 风险是:
- Molmo 定位错误会进入训练数据;
- 轨迹可能经过障碍物,但二维折线本身无法表达碰撞关系;
第三层:Action Tokens
三阶段的概率分解可以简化为:
每一层内部也进行自回归生成:
即:
- 先生成完整深度 token;
- 再根据深度生成运动轨迹;
- 最后根据深度和轨迹生成动作。
论文证明了
- 空间中间监督可以与自回归 VLA 统一训练;
- 深度和轨迹可以作为可解码的控制前置变量;
- 高质量中训练数据有正向作用;
- 视觉轨迹是一个有潜力的人机控制接口; 最有价值的思想是把机器人“思考”从抽象文字变成可执行空间变量:看懂空间→画出路径→产生动作