论文笔记 · 2026/07/17
π0.5
π0.5: a Vision-Language-Action Model with Open-World Generalization
https://arxiv.org/abs/2504.16054
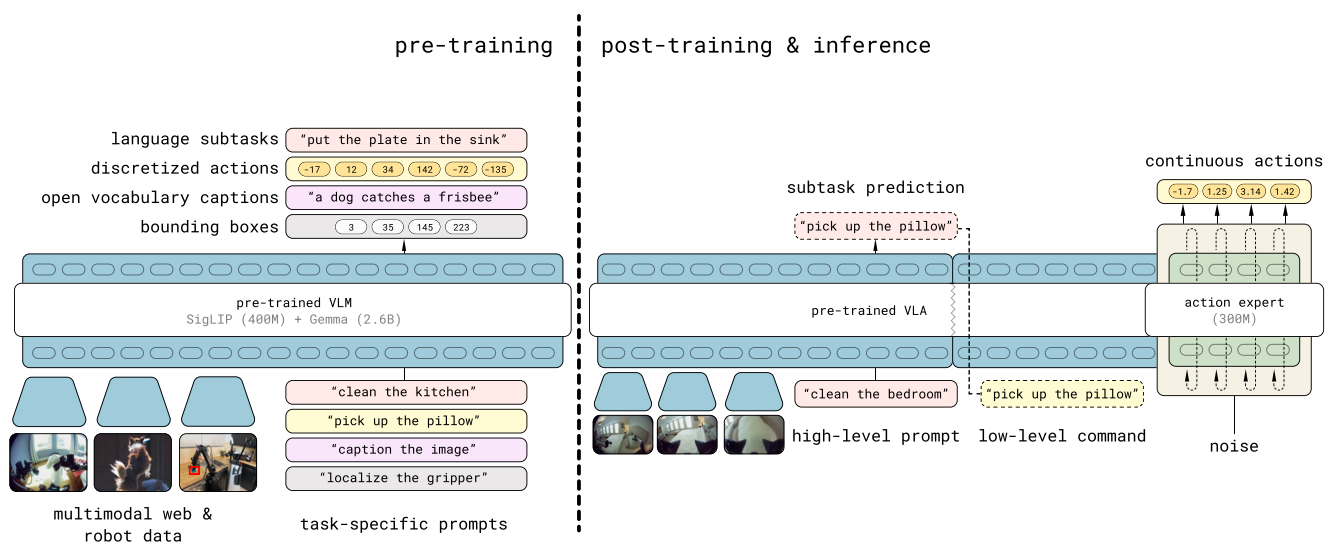
继承了 的 flow-matching action expert(https://www.songbozhang.top/article/pi0) 和 FAST(https://www.songbozhang.top/article/fast) 的离散动作 tokenization,在统一 VLA 内加入类似 Plan–Execute / embodied CoT 的层级推理:先以自回归方式预测一个语言子任务,再以该子任务为条件生成连续低层动作。
训练上先进行纯离散 next-token pre-training,再加入 action expert,在 post-training 中联合优化 token loss 与 flow-matching loss,并通过异构机器人数据、高层标注和 Web 多模态数据提升开放世界泛化
传统机器人策略往往只能在相似环境中执行短任务。
关注:在未见过的房屋、布局和物体上,机器人能否理解长程指令,并连续完成多个操作步骤
模型结构
将策略分解为: $\pi(a,\hat{\ell}\mid o,\ell)
\pi(\hat{\ell}\mid o,\ell) \cdot \pi(a\mid o,\hat{\ell})$
其中:
- o:当前视觉与机器人状态;
- :用户的长程任务;
- :模型预测的下一条子任务;
- a:连续机器人动作。
推理流程:
这类似 Plan–Execute / embodied CoT,但模型通常只生成当前下一步,而不是一次生成完整计划。
训练
Pre-training
只训练离散 next-token prediction:
离散输出包括:
- 文本;
- 高层子任务;
- bounding box;
- FAST 动作 token;
- VQA、caption 等 Web 任务。
FAST 让连续机器人动作能够作为 token 与语言和视觉任务统一训练。
Post-training
加入 式 flow-matching action expert:$\mathcal L
\mathcal L_{\text{token}} + \alpha\mathcal L_{\text{flow}}$
作用:
- token loss 保留语言、语义和高层推理能力;
- flow loss 学习实时、精细的连续动作控制。
数据组成
| 数据 | 主要作用 |
|---|---|
| 目标移动机器人数据 MM | 学习完整家庭任务与目标 embodiment |
| 多家庭固定机械臂数据 ME | 扩展环境和物体多样性 |
| 跨机器人实验室数据 CE | 扩展技能和 embodiment |
| 高层子任务标注 HL | 学习任务分解和任务阶段 |
| Web 多模态数据 WD | 学习开放词汇、物体与场景语义 |
| 语言遥操作数据 VI | 学习适合当前低层策略的子任务序列 |
核心思想:
实验结论
- 能在未参与训练的新家庭中完成收拾餐具、整理床铺、收衣物等长程任务。
- 训练环境数量越多,新环境泛化越好。
- 跨 embodiment 数据能够明显提升目标机器人的操作能力。
- Web 数据主要提升陌生物体识别、语言跟随和高层决策。
- 高层子任务监督非常重要;即使部署时不显式输出子任务,训练过高层监督的模型仍明显更强。
- 外部通用 VLM 作为高层 planner 表现较差,说明高层策略必须与机器人的真实能力和低层策略相匹配。
局限
仍然缺乏:
- 稳定的长期记忆;
- 显式任务完成状态;
- 防止高层规划循环的机制;
- 对全新物理结构的强泛化;
- 复杂约束和用户偏好的可靠理解;
- 不确定性判断与主动求助能力。