论文笔记 · 2026/07/17
FAST
FAST:Efficient Action Tokenization for Vision-Language-Action Models
https://arxiv.org/abs/2501.09747
要解决的问题
传统 VLA 将连续动作按“时间点 × 动作维度”逐个离散成 token:
如果未来动作长度为 H,动作维度为 D,就需要生成:个 token。
在高频控制下,相邻动作几乎相同,导致:
- token 序列很长;
- 相邻 token 高度重复;
- 模型容易学成“复制上一个动作”;
- 有效监督信号弱,训练效率低。
具体方法:FAST
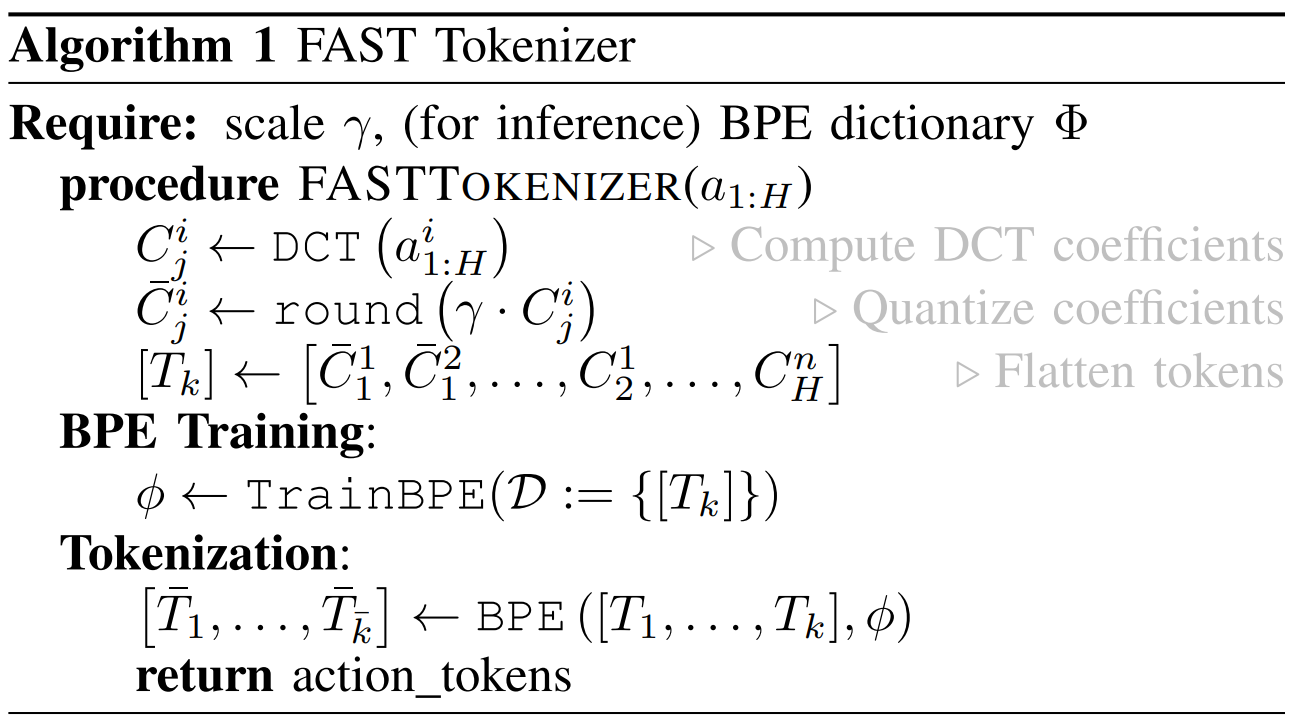
设一段动作序列为:
其中每一行是一个动作维度,每一列是一个时间点。
1. 动作归一化
对每个动作维度,根据训练集的第 1 和第 99 百分位进行缩放,将动作大致映射到:
这样可以减小不同机器人、不同动作单位之间的数值差异,并降低异常值影响。
2. 沿时间轴做 DCT
对每个动作维度的一整段时间轨迹分别做离散余弦变换:
即:$[a_{d,1},a_{d,2},\ldots,a_{d,H}] \rightarrow [c_{d,0},c_{d,1},\ldots,c_{d,H-1}]$
其中:
- 表示整体平均或恒定成分;
- 前几个系数描述缓慢变化趋势;
- 后面的系数描述快速变化和高频细节。
由于机器人动作通常较平滑,绝大部分信息集中在低频系数中,高频系数通常接近零。
3. 量化频率系数
将 DCT 系数乘以缩放因子 ,再四舍五入为整数:
论文单数据集实验通常使用:
例如:
量化后变成:
较小的高频系数会直接变为零。
越小,压缩越强,但重建误差越大; 越大,动作越精确,但 token 更多。
4. 按频率优先展开
将二维频率系数矩阵展开成一维整数序列。
FAST 先排列所有动作维度的低频系数,再排列更高频系数:
这样模型首先预测决定动作整体形状的低频信息,再预测较小的高频细节。
5. 使用 BPE 压缩
量化后的序列包含大量零和重复系数组合,例如:
使用 BPE 学习常见连续模式,并将它们合并为单个 token,例如:
因此,BPE 同时压缩:
- 连续零;
- 常见低频系数组合;
- 不同动作维度之间经常共同出现的模式。
最终得到较短的动作 token 序列。
6. 动作解码
执行时反向恢复动作:
最后再进行反归一化,恢复机器人可执行的连续动作。
效果
- 动作 token 数减少约 2~13 倍;
- 在高频、双臂和灵巧操作任务上,明显优于传统逐点离散化;
- 策略性能与 diffusion VLA 基本相当;
- 达到相近性能所需训练计算量最多减少约 5 倍;
- 主要缺点是自回归生成速度较慢,在线推理延迟高于 diffusion 方法。
核心结论:VLA 不应逐点描述高频动作,而应先压缩整段动作中的时间冗余,再进行 token 预测。