论文笔记 · 2026/07/22
DreamVLA
DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge
https://arxiv.org/abs/2507.04447
DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge
解决了什么问题
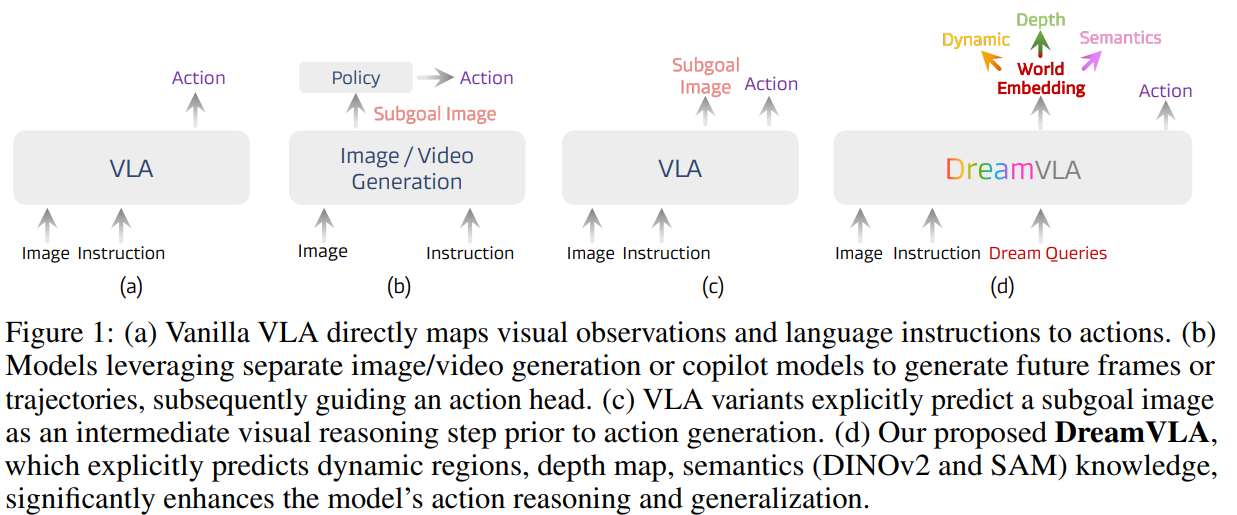
现有VLA通常直接根据当前图像、语言指令和机器人状态生成动作,缺少对未来状态的显式预测,因而容易表现为“看到什么就立即反应”,对长程操作和复杂空间关系的理解有限。
已有部分方法通过预测完整未来图像辅助规划,但完整图像包含大量静态背景和无关像素,计算成本高,也不能明确表达物体运动、空间深度和任务语义。
DreamVLA 要解决的核心问题是:如何让机器人在执行动作前预测与控制真正相关的未来世界信息,同时避免生成完整未来图像带来的冗余和计算开销。
解决问题的思路
DreamVLA 将传统的直接动作生成流程:
改为:
模型不预测完整未来 RGB 图像,而是预测三类更紧凑、与操作任务相关的未来知识:
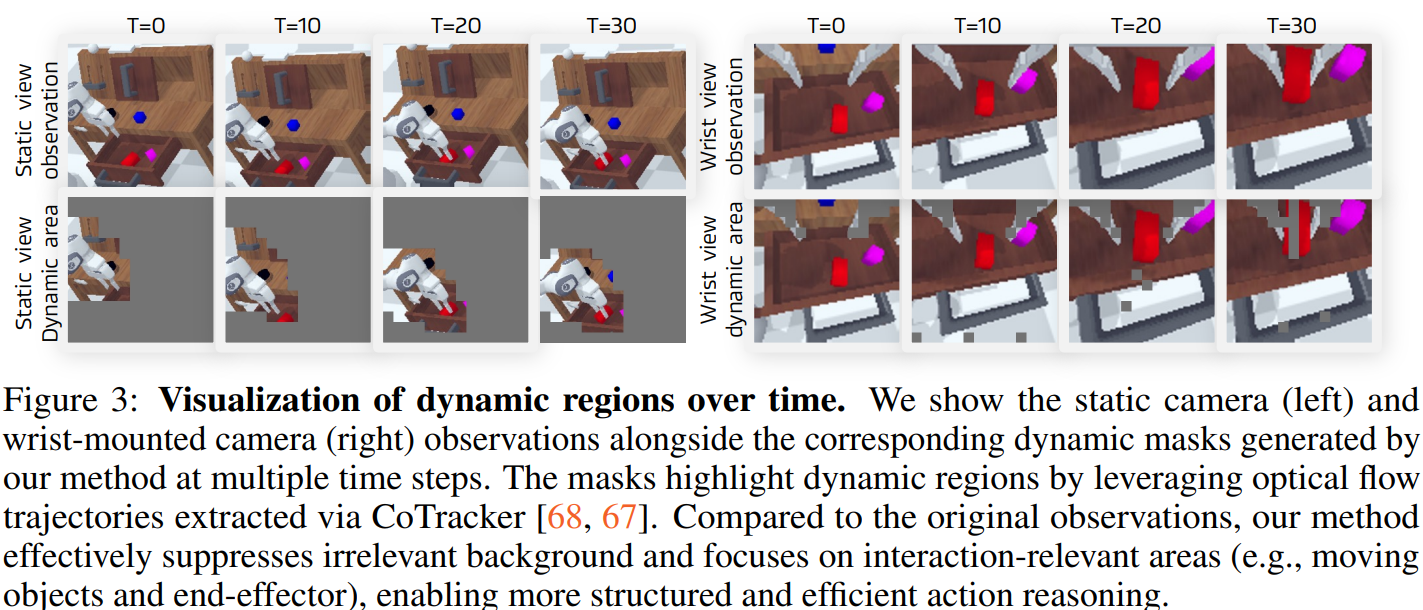
- 动态区域:未来哪些位置会发生运动,例如机械臂、被操作物体和目标区域。
- 深度信息:物体、障碍物和机械臂之间的前后空间关系。
- 语义信息:当前任务中哪些对象和区域最重要。
这些预测任务只在训练阶段用于约束模型的内部表示。实际推理时,模型不需要显式生成动态图、深度图或语义图,而是直接使用已经学习到的未来世界表示生成动作,因此额外推理开销较小。
具体架构与方法
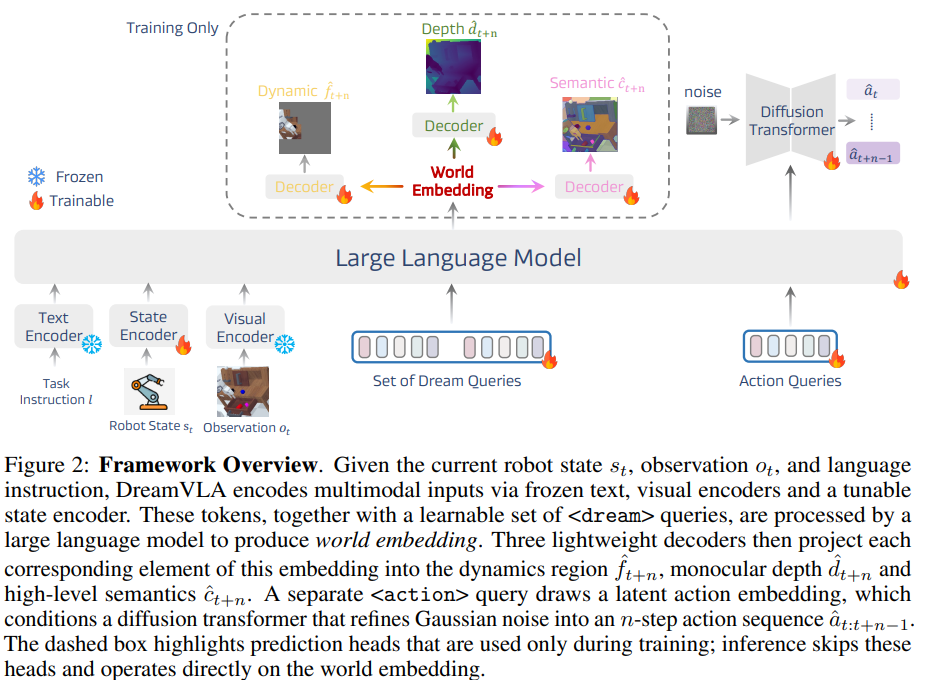
DreamVLA 的输入包括语言指令、第三人称与腕部摄像头图像,以及机器人末端位姿和夹爪状态。
模型主要由以下部分组成:
多模态编码与融合
- 使用 CLIP 文本编码器处理语言指令;
- 使用 ViT 视觉编码器提取多视角图像特征;
- 使用 MLP 编码机器人自身状态;
- 使用 Transformer 融合语言、视觉和状态信息。
Dream Queries
模型加入三组可学习的 Dream Queries,分别负责提取:
- 动态区域表示;
- 深度表示;
- 语义表示。
三组 Query 可以读取相同的输入信息,但彼此之间的注意力连接受到限制,避免不同预测任务相互干扰。随后,Action Query 综合这些未来世界表示,形成用于动作生成的条件特征。
世界知识预测
训练阶段设置三个主要辅助目标:
- 利用 CoTracker 生成未来动态区域监督;
- 利用真实深度或 Depth Anything 生成未来深度监督;
- 利用 SAM、DINOv2 等视觉模型生成未来语义特征监督。
这些解码器仅在训练时使用,部署时可以移除。
动作生成
DreamVLA 使用扩散 Transformer 生成连续动作序列。模型从随机噪声开始,在未来世界表示的条件下逐步去噪,最终得到机械臂位姿变化和夹爪开合动作。
扩散动作头能够表示多种可能的正确操作轨迹,减少普通回归模型把不同轨迹平均成无效动作的问题。
4. 取得了什么效果
DreamVLA 在仿真和真实机器人实验中均取得了较好的结果。
CALVIN 长程操作
在连续执行 5 个任务的 CALVIN 基准上:
- 平均连续完成任务数达到 4.44;
- 连续完成全部 5 个任务的成功率达到 78.1%;
- 超过论文比较的其他 VLA 和未来预测方法。
LIBERO 操作任务
在 LIBERO 的空间理解、物体操作、目标理解和长程任务中,DreamVLA 的平均成功率约为 92.6%,在空间、物体和长程任务上表现尤其突出。
真实机器人实验
在抓取、放置和抽屉开关等真实 Franka 机械臂任务上:
- DreamVLA 总体成功率达到 76.7%;
- Diffusion Policy 为 50.8%;
- Octo-Base 为 45.0%;
- OpenVLA 为 35.0%。
消融实验结论
实验显示:
- 动态区域预测贡献最大;
- 深度和语义信息能够在动态区域基础上进一步提升性能;
- 预测未来知识优于重建当前画面;
- 动态区域预测优于完整光流预测;
- 分离不同知识的 Dream Queries 优于共享 Query;
- 结构化注意力显著优于普通因果注意力。
总结
DreamVLA 的核心贡献是:在 VLA 模型中加入轻量化的未来世界预测,但不生成完整未来图像,而是预测动态区域、深度和语义等与动作直接相关的信息。
其主要经验可以概括为:
机器人不需要完整重建未来世界,只需要预测未来哪些部分会变化、这些部分位于哪里,以及哪些对象与任务最相关。
这种设计提升了模型的长程操作和真实机器人控制能力,同时只带来较小的推理开销。