论文笔记 · 2026/07/18
Gemini Robotics
Gemini Robotics: Bringing AI into the Physical World
#VLA#Layered architecture
Gemini Robotics: Bringing AI into the Physical World
https://arxiv.org/abs/2503.20020
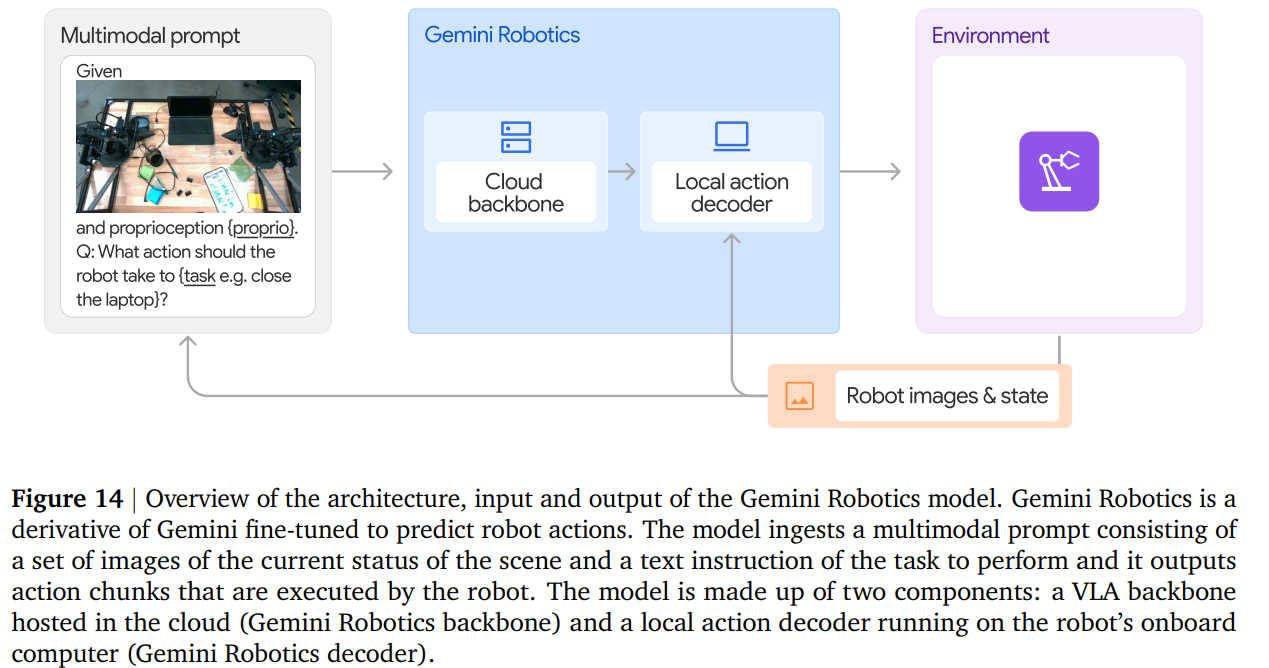
Gemini Robotics 的核心是用 Gemini 负责理解和推理,用本地动作解码器负责实时执行,从而把视觉语言模型转化为可泛化的机器人控制系统。
设计架构
论文提出两层机器人模型体系:
Gemini Robotics-ER
负责视觉理解、空间推理、目标定位、抓取点预测和任务规划。
Gemini Robotics
在 Gemini 视觉语言模型基础上加入动作输出能力,形成 VLA 模型:
其中,云端主干负责语义理解和高层决策,本地解码器负责实时生成低层动作。模型采用 Action Chunking,一次预测一段未来动作,以降低云端延迟并保持连续控制。
推理增强版本还引入:
通过显式轨迹中间表示,将抽象推理与精确动作连接起来。
主要创新
- 将 Gemini 的视觉语言能力扩展为可直接输出机器人动作的 VLA 模型。
- 采用“云端大模型+本地动作解码器”的分层架构,兼顾大模型能力与实时控制。
- 使用动作分块预测,缓解网络和模型推理延迟。
- 将开放词汇理解、空间推理和世界知识引入机器人操作。
- 支持未见物体、新指令、新环境和不同机器人形态的泛化。
- 通用模型可通过少量示范快速适应新任务,也可微调为高精度专家。
- 在传统物理安全之外,引入基于场景语义的动作安全判断。