论文笔记 · 2026/07/20
Cosmos-Reason1
Cosmos-Reason1: From Physical Common Sense To Embodied Reasoning
Cosmos-Reason1: From Physical Common Sense To Embodied Reasoning
https://arxiv.org/pdf/2503.15558
Cosmos-Reason1 通过物理能力体系、专项视频推理数据、监督微调和可验证强化学习,把通用视觉语言模型改造成能够理解物理规律并给出高层具身决策的视频推理模型。
解决的问题
现有语言模型和视觉语言模型虽然具有较强的文本推理能力,但难以把知识可靠地落到真实物理世界中,尤其缺乏两类能力:
- 物理常识推理:理解空间关系、事件顺序、因果、物体状态、力学和物体恒存等;
- 具身推理:根据视频观察和任务目标,判断任务是否完成、某个动作是否可执行,以及下一步应该采取什么动作。
论文的目标是训练一个能够从视频中理解物理世界,并用自然语言给出推理过程和高层具身决策的多模态模型
提出的方法
论文采用以下路线:
定义能力体系
建立两套 ontology:
- 物理常识:空间、时间、基础物理,共 16 个细分类别;
- 具身推理:复杂感知、动作效果预测、物理约束和交互学习。本文主要训练前三项
构建专项训练数据
使用人工标注、视频字幕和 DeepSeek-R1 蒸馏生成两类数据:
- 理解数据:描述视频中的物体、状态和动作
- 推理数据:包含问题、长思维链和答案
数据覆盖物理常识、机器人操作、自动驾驶,以及空间拼图、时间箭头和物体恒存等直觉物理任务
两阶段 Physical AI 后训练
视觉预训练。使用约 1.2 亿条图像、视频和图文交错数据,将视觉信息对齐到语言模型的 Token 表示空间。这一阶段冻结视觉编码器和 LLM,仅训练两层 MLP Projector:
通用监督微调。使用约 800 万条通用视觉语言数据,包括:
- 600 万条图像—文本数据;
- 200 万条视频—文本数据。
该阶段对视觉编码器、Projector 和 LLM 进行端到端训练,使模型具备通用图像与视频理解能力。
Physical AI SFT:让模型学习视频中的物理常识和具身任务推理
Physical AI RL:采用 GRPO,通过选择题正确性和输出格式构造规则化、可验证奖励,进一步提升推理能力
3. 模型架构
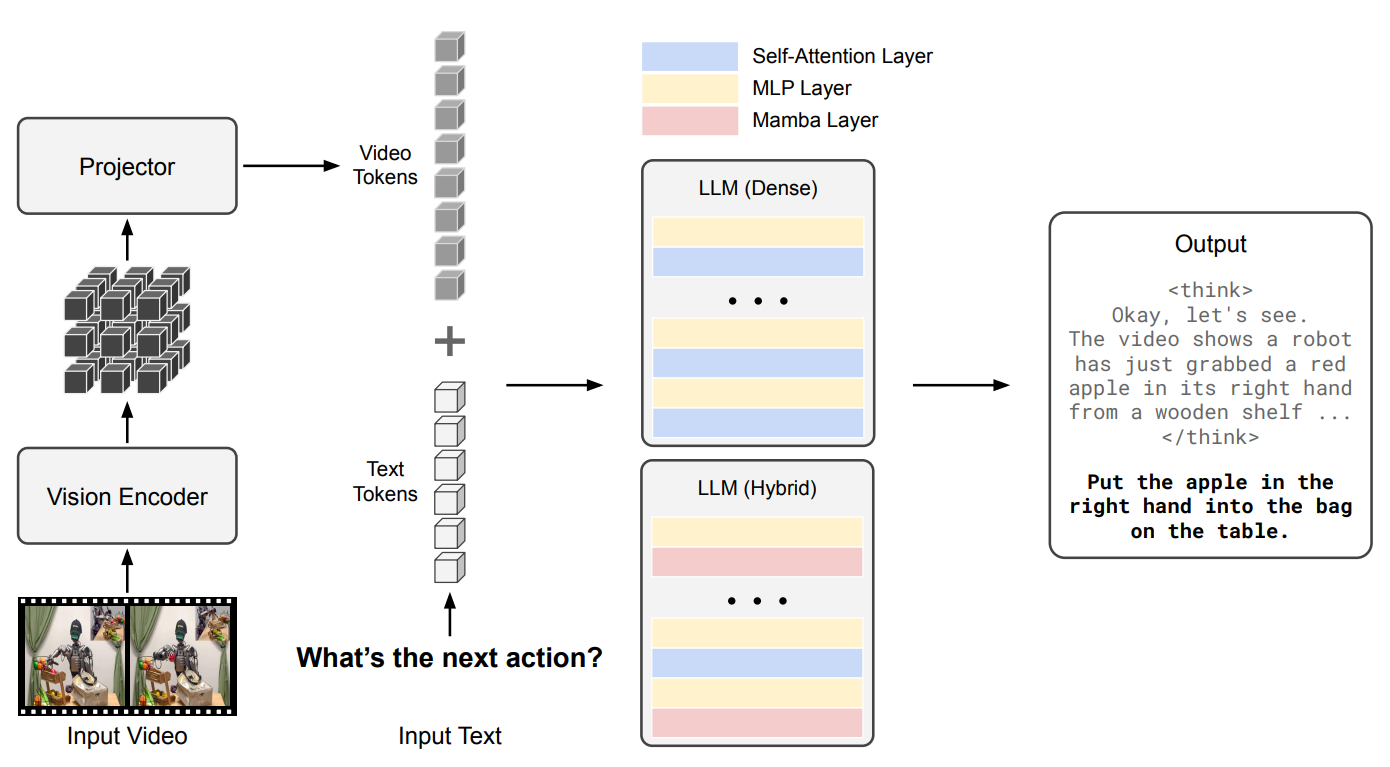
模型采用 decoder-only 多模态架构:
各模块作用如下:
- 视觉编码器:从视频帧中提取视觉特征;
- 投影器:将视觉特征映射到语言模型的 Token 嵌入空间;
- Decoder-only LLM:统一处理视觉和文字 Token,并输出自然语言推理与决策。视频最多均匀采样 32 帧,视觉 Token 会经过下采样以降低长视频的计算开销。
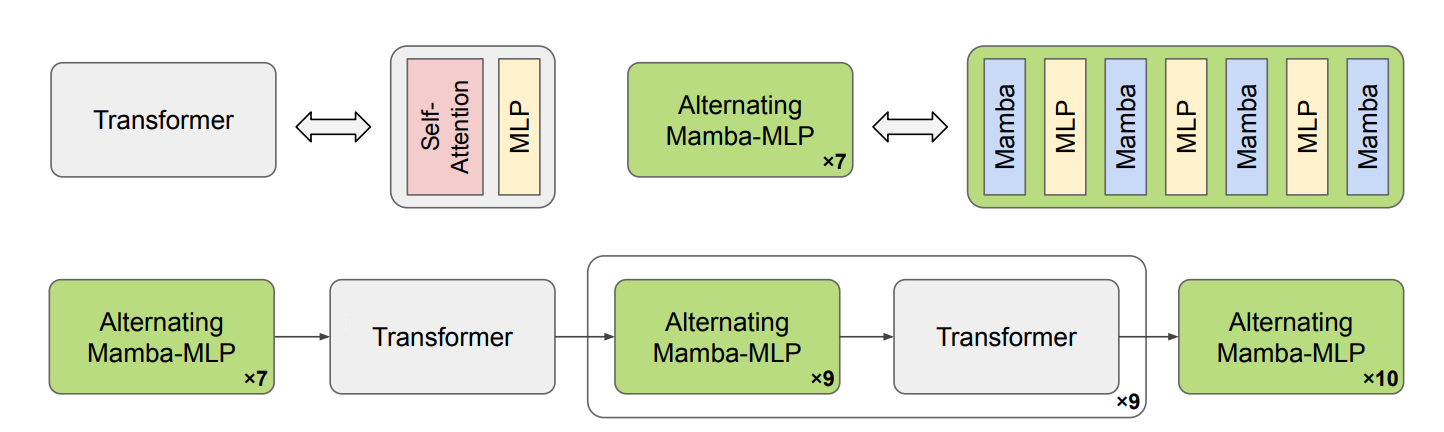
语言模型主干采用 Hybrid Mamba-MLP-Transformer:
- Mamba 层以近似线性复杂度处理长视频 Token 序列;
- Transformer 层负责捕获远距离、全局信息关系;
- MLP 层完成非线性特征变换。
这种混合设计试图兼顾长上下文处理效率与复杂全局推理能力