论文笔记 · 2026/07/17
LingBot-VLA
A Pragmatic VLA Foundation Model
#VLA
https://arxiv.org/pdf/2601.18692v4
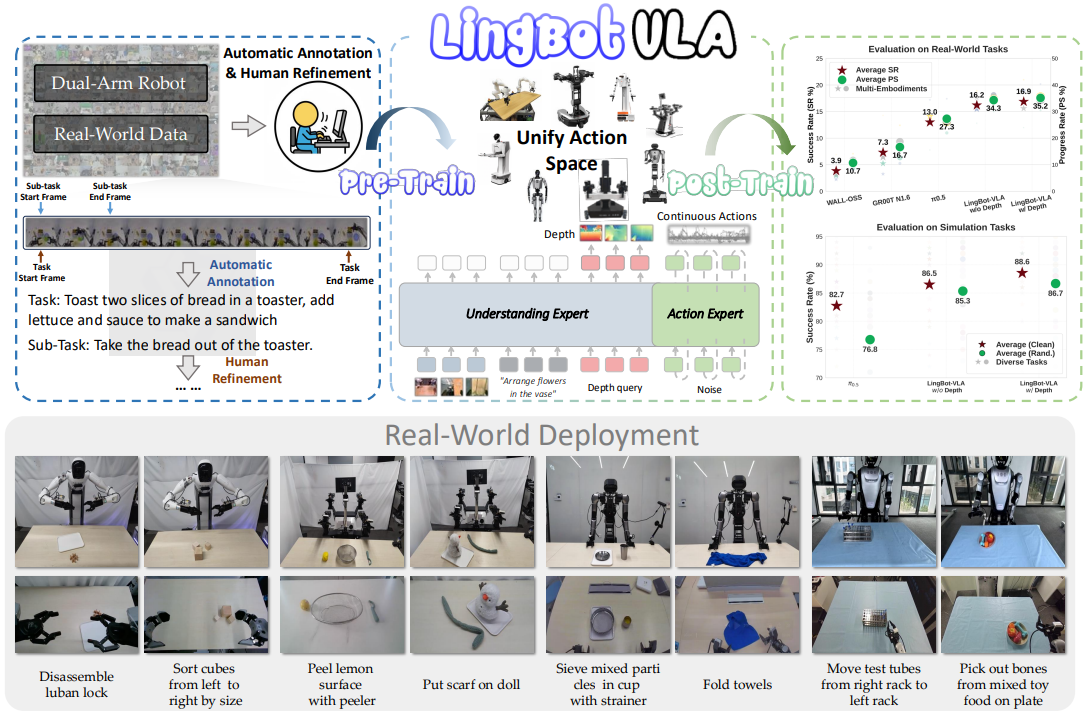
数据
- 约 20,000 小时真实遥操作数据
- 覆盖 9 种双臂机器人
- 每条数据包含三路相机图像、语言指令、机器人状态和动作轨迹
- 使用大模型自动生成任务及子任务描述,再由人工校正
模型结构
采用 Mixture-of-Transformers:
- Understanding Expert:基于 Qwen2.5-VL,处理图像和语言
- Action Expert:处理机器人状态及加噪动作,生成连续动作轨迹
两个专家拥有各自参数,但在每一层通过联合注意力交换信息。
数据流为:
图像、语言 → 理解专家
机器人状态、加噪动作 → 动作专家
两者逐层交互 → 输出未来 50 步动作
动作生成
模型使用 Flow Matching
训练时,把真实动作与随机噪声混合,让模型学习从噪声指向真实动作的速度场。
推理时:
随机动作噪声 → 多次迭代修正 → 连续动作轨迹
动作块内部允许双向注意,因此模型可以整体协调抓取、移动和放置过程。
空间能力
论文加入深度蒸馏:
- LingBot-Depth 作为教师模型
- 训练 RGB 视觉特征保留更多三维空间信息
- 推理时通常不需要额外输入深度图
训练优化
训练框架使用:
- FSDP 参数分片
- bfloat16 存储与通信
- FlexAttention 稀疏注意力
torch.compile算子融合
8 张 GPU 的总吞吐量为 261 samples/s。
关键实验结论
数据规模
预训练数据从 3,000 小时扩大到 20,000 小时时,下游性能总体持续提高,尚未明显饱和。
但论文只展示经验趋势,没有建立严格的数学缩放定律
数据效率
在部分任务中,LingBot-VLA 使用每任务 80 条示范,就超过了 使用 130 条示范的表现。
说明更强的预训练能够减少新任务的数据采集成本