论文笔记 · 2026/07/20
Cosmos WFM
Cosmos World Foundation Model Platform for Physical AI
Cosmos World Foundation Model Platform for Physical AI
https://arxiv.org/abs/2501.03575
一、定位
Cosmos 是一套面向机器人、自动驾驶和工业智能系统的世界基础模型平台。
其核心任务可以概括为:给定历史视觉观测,以及动作、文本指令或相机轨迹等外部条件,预测物理世界接下来可能出现的视觉状态。
形式上,世界模型学习的是条件概率:
其中, 表示历史图像或视频, 表示机器人动作、车辆控制、文本指令或其他外部扰动。
Cosmos 的主要贡献是将以下环节组织成统一基础设施:
这套平台允许开发者复用通用的视觉和物理先验,再用较少的领域数据适配具体任务。
二、视频数据整理
Cosmos 从约 2000 万小时、分辨率覆盖 720p 至 4K 的原始视频中,整理出约 1 亿个长度为 2~60 秒的视频片段。
数据处理流程主要包括:
- 镜头切分;
- 质量过滤;
- 视频描述生成;
- 语义去重;
- 按分辨率、比例和时长分片。
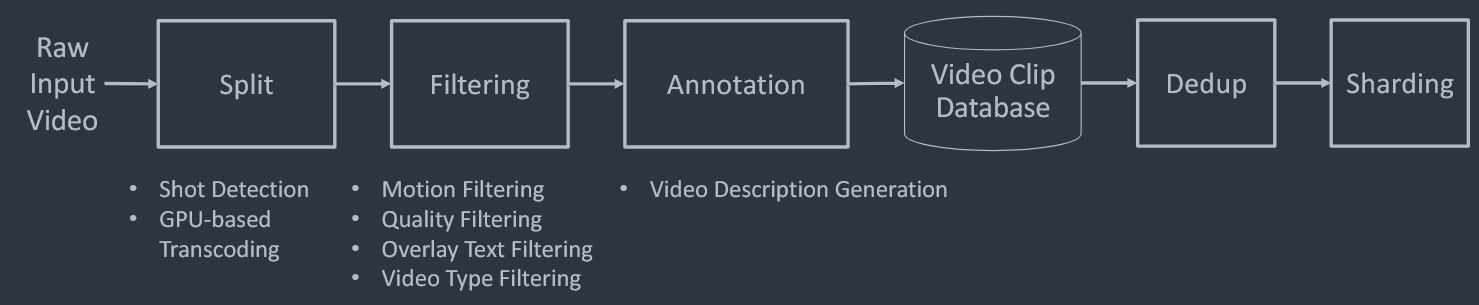
镜头切分用于排除剪辑转场,避免模型将不连续场景误认为真实物理变化。
质量过滤则删除静止、低清晰度、剧烈抖动、过曝、含大量文字特效、动画或游戏画面的片段。
平台使用约 13B 参数的 VILA 模型生成详细视频描述,作为文本条件参与世界模型训练。整个数据流水线基于 Ray 构建,以并行调度视频解码、网络传输和 GPU 推理。
Cosmos 所需要的是具有连续运动、空间变化、物体接触和自然动态的信息密集型数据。
三、因果视频 Tokenizer
直接在高清像素空间训练长视频模型成本过高,因此 Cosmos 先将视频压缩为时空 Token。
其关键设计是时间因果性:编码当前帧时,只允许使用当前帧和历史帧的信息,不能依赖未来帧。
这一设计对于机器人和自动驾驶尤为重要。在线系统只能接收到已经发生的观测,无法在编码当前状态时“偷看未来”。
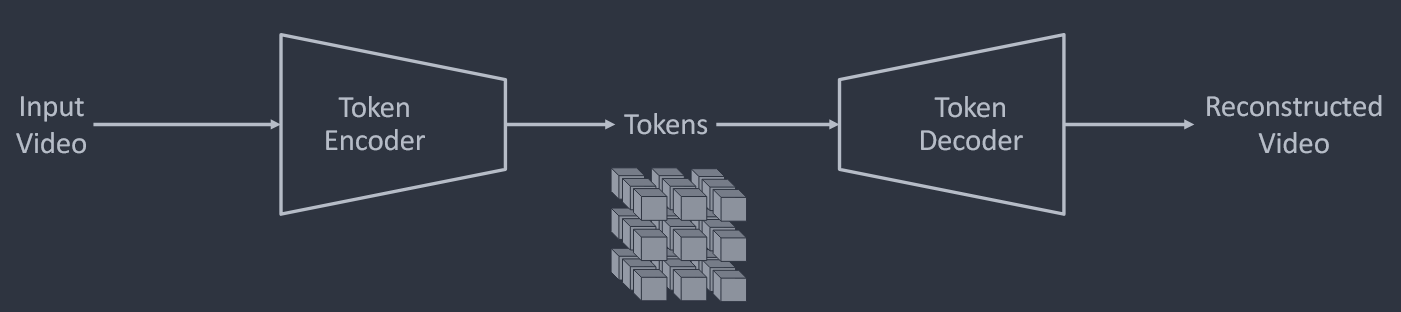
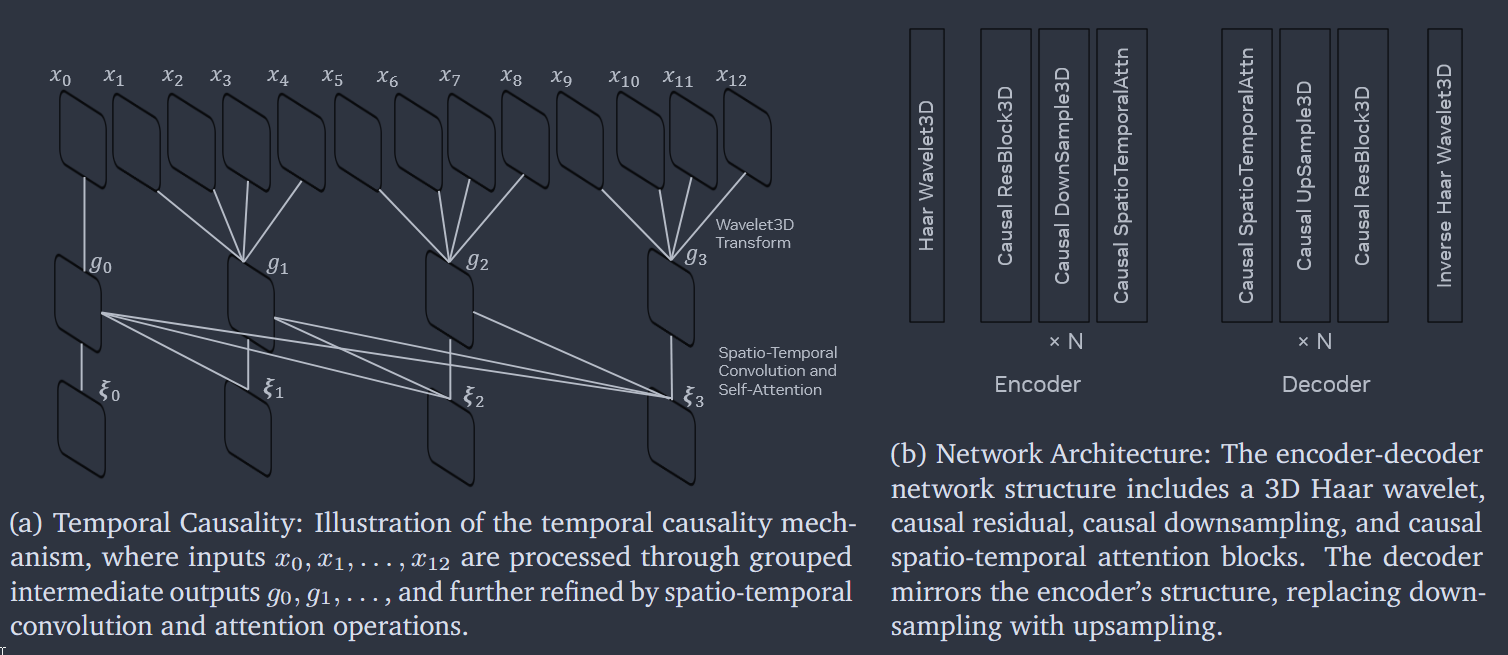
Tokenizer 采用编码器—解码器结构,主要包含:
- 3D Haar 小波变换;
- 因果残差模块;
- 时空分解卷积;
- 因果时空注意力;
- 时间维度左侧填充。
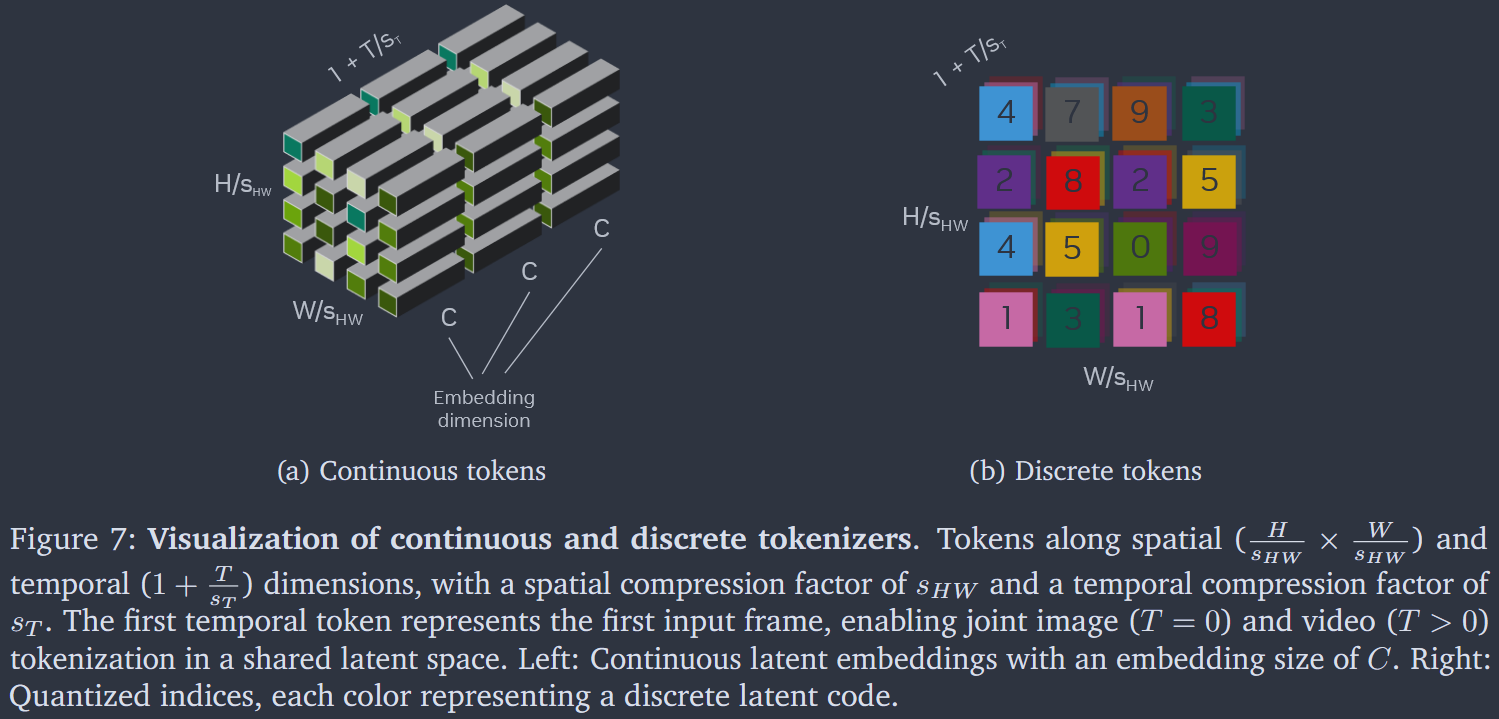
平台提供两种视频表示。
1. 连续视频 Tokenizer
型号为 CV8×8×8
它在时间、高度和宽度三个维度上均压缩 8 倍,输出连续潜变量,主要供扩散世界模型使用
2. 离散视频 Tokenizer
型号为 DV8×16×16
它在时间维度压缩 8 倍,在空间维度压缩 16 倍,并通过有限标量量化将潜变量映射为离散 Token,主要供自回归世界模型使用
更高的空间压缩率可以显著缩短自回归序列,但也会损失纹理和高频细节
Tokenizer 训练使用像素级 L1 损失、VGG 感知损失、光流损失、纹理损失和对抗损失,以兼顾图像质量、时间连续性与压缩效率
四、双路线世界基础模型
Cosmos 同时训练扩散模型和自回归模型,以覆盖不同的应用需求
4.1 Diffusion WFM
扩散模型包括 7B 和 14B 两种规模。
训练分为两个阶段:
- Text2World:根据文本描述生成视频;
- Video2World:根据历史图像或视频以及外部条件预测未来。
模型工作在 CV8×8×8 连续潜空间中,采用 EDM 风格的去噪目标,并使用 Transformer 作为去噪网络。
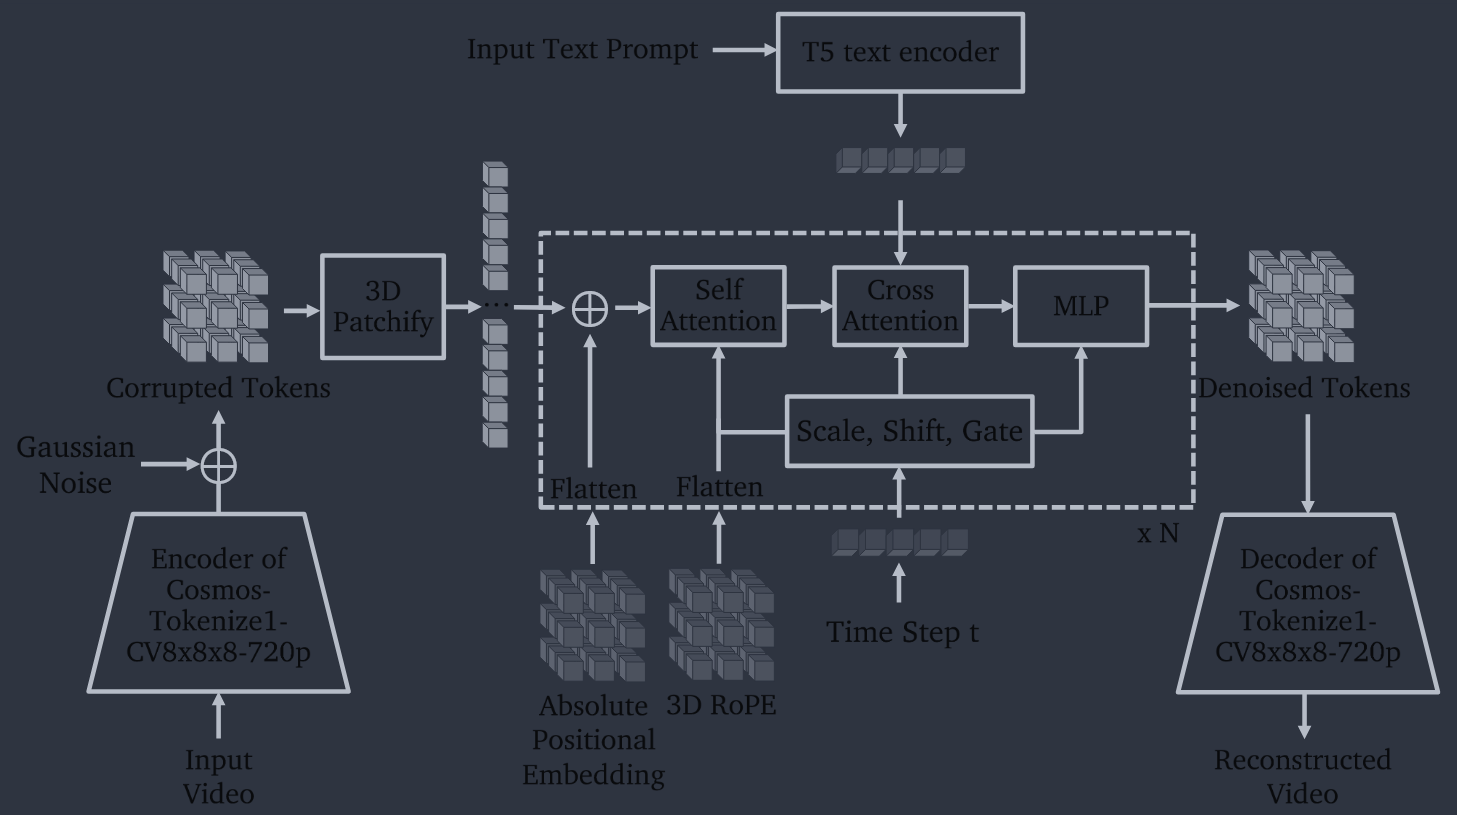
训练 Video2World 时,历史条件帧与目标帧共同输入模型,并使用掩码区分已知区域和待预测区域。损失只在目标区域计算。
训练过程中会随机改变条件帧数量,因此模型在推理时既可以接收单张图像,也可以接收多帧历史视频。
扩散路线的主要优点是:
- 视觉质量较高;
- 纹理细节更完整;
- 多视角和全局空间一致性更好。
其主要不足是采样步骤较多,推理速度相对较慢。
Cosmos 还使用基于 Mistral-NeMo-12B-Instruct 的 Prompt Upsampler,将简短提示扩展为详细的视频描述,从而改善复杂场景生成效果。
4.2 Autoregressive WFM
自回归模型首先训练 4B 和 12B 的基础模型,随后加入文本条件,形成约 5B 和 13B 的 Video2World 模型。
模型结构接近 GPT,通过预测下一个离散视频 Token 生成未来序列,并使用:
- DV8×16×16 离散 Token;
- 自注意力;
- 文本交叉注意力;
- Query-Key Normalization;
- z-loss;
- 绝对与相对位置编码。
文本由 T5-XXL 编码,并通过交叉注意力注入视频生成过程。
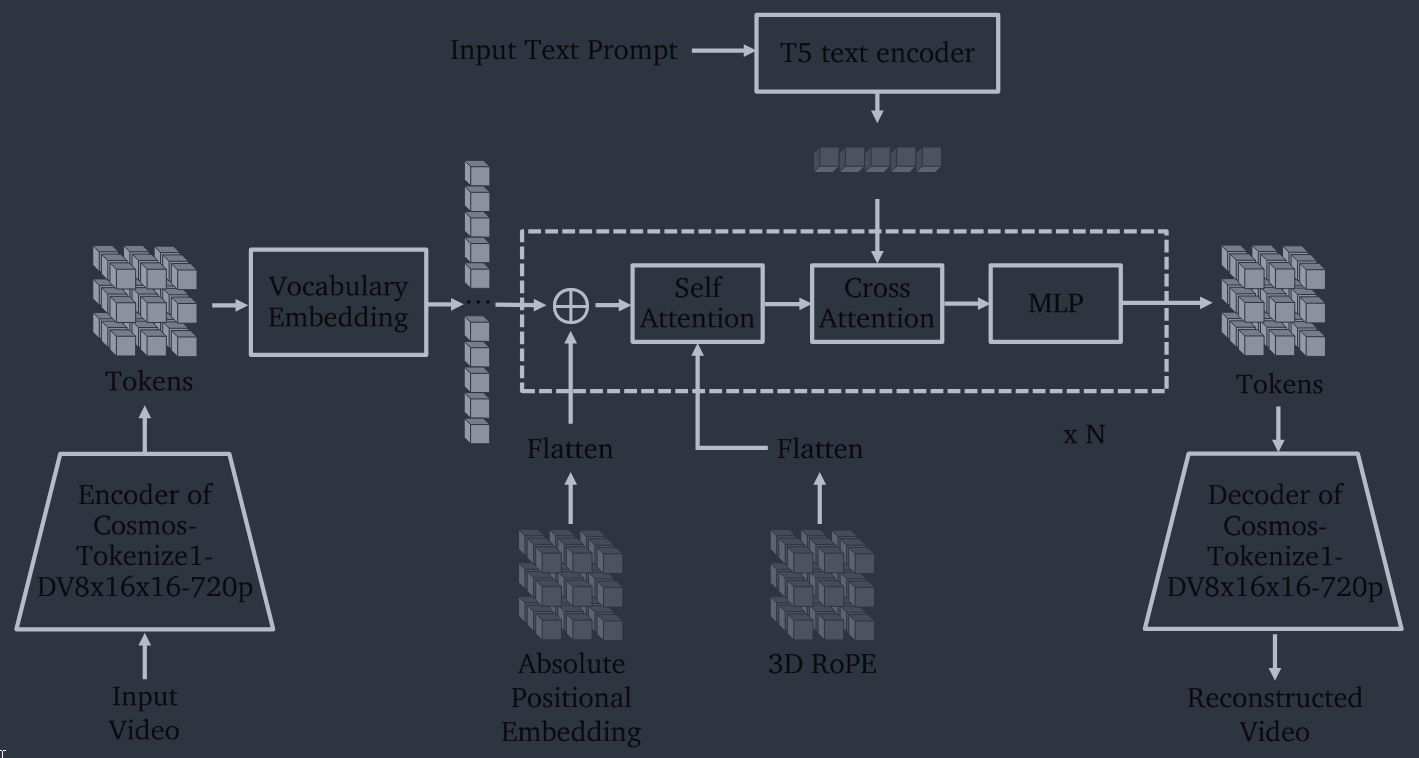
训练首先让模型根据首帧预测后续视频,再扩展上下文长度,最后加入文本条件进行联合训练。
自回归模型的优势是:
- 适合序列预测;
- 可以复用大语言模型的推理优化技术;
- 更容易实现低延迟生成。
为提高推理速度,Cosmos 引入 KV Cache、张量并行、torch.compile 和 Medusa 推测解码。
在经过特定分辨率和领域适配后,4B 自回归模型配合 Medusa,在 8 张 H100 GPU 上达到约 10 FPS,显示出接近实时世界生成的潜力。
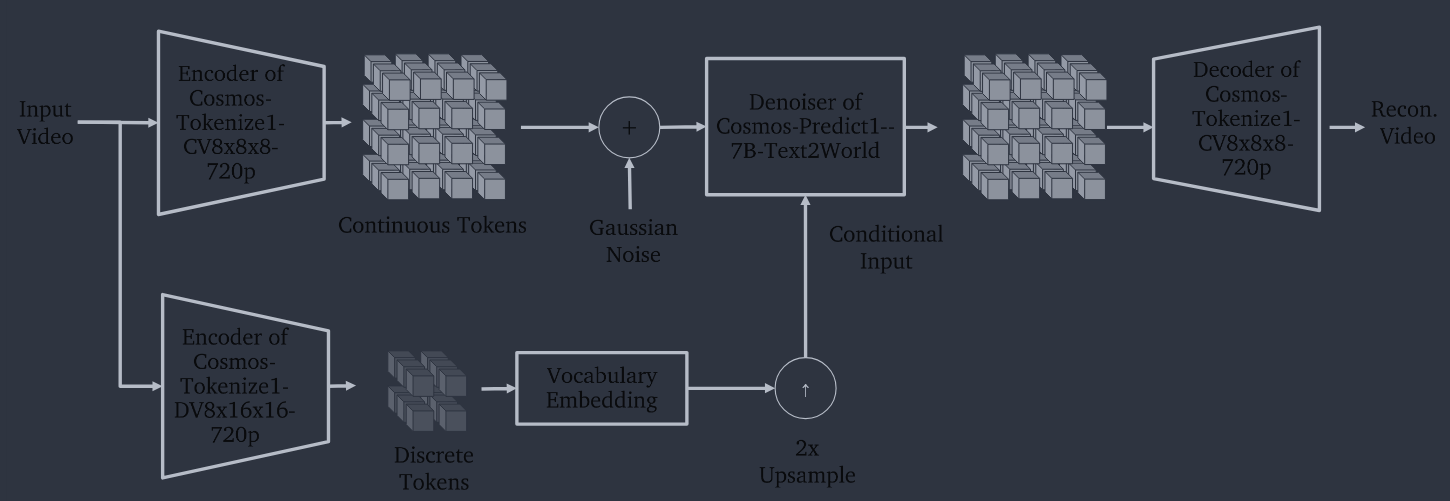
由于离散 Token 的高压缩率会损失细节,Cosmos 还训练了一个 7B 扩散解码器,将自回归模型生成的离散表示映射回高质量连续潜空间,以恢复边缘、纹理和高频信息。
五、领域后训练
预训练模型只获得通用视觉和动态先验,并不能直接完成具体任务。因此,Cosmos 通过后训练适配不同 Physical AI 场景。
论文展示了三类典型任务。
1. 相机控制
模型以相机位姿或轨迹为条件生成新视角,用于构建可导航、具有一定三维一致性的虚拟环境。
在相关实验中,经过后训练的 Cosmos 位姿估计成功率达到 82.0%,而对比模型 CamCo 为 43.0%。
2. 机器人操作
模型接收语言指令或机器人动作序列,并预测执行动作后的视觉结果。
在 Bridge 机器人数据集上,Cosmos Diffusion-7B 的 FVD 为 190,优于 IRASim-Action 的 593。
这说明通用世界模型经过领域微调后,可以学习动作与视觉结果之间的映射。
3. 自动驾驶
Cosmos 针对六路车载摄像头进行多视角联合生成,并加入车辆运动轨迹作为条件。
这一任务要求模型同时保持:
- 不同摄像头之间的空间一致性;
- 时间方向上的运动连续性;
- 车辆轨迹与视觉变化的一致性。
六、与传统物理仿真器的关系
Cosmos 并不取代 Isaac Sim、MuJoCo 或 PhysX。
传统物理仿真器从显式状态和动力学方程出发,依赖质量、摩擦系数、碰撞体和关节约束等参数,具有以下优势:
- 物理规则明确;
- 状态可以直接读取;
- 实验可重复;
- 控制变量精确。
但传统仿真器通常需要大量人工建模,而且渲染结果与真实世界之间可能存在明显的 Sim-to-Real 差距。
Cosmos 从真实视频中学习隐式世界动态,优势是:
- 视觉真实性更高;
- 可以覆盖开放环境;
- 能生成复杂场景变化和长尾数据。
但其生成结果不保证严格满足动力学方程。
因此,二者更合理的关系是互补:
- 仿真器提供精确、可控、可验证的物理环境;
- 世界模型提供真实感、开放世界先验和数据驱动生成;
- 仿真器还可以为世界模型提供训练数据和物理评测标准。
七、评估方法
传统视频生成指标主要衡量画质和视觉真实性。Cosmos 进一步评估三维几何、物理动态和领域适配能力。
1. 三维几何一致性
论文在 RealEstate10K 静态场景中,使用以下指标检验生成视频是否具有稳定的三维结构:
- Sampson Error;
- 相机位姿估计成功率;
- 新视角重建质量。
Cosmos Diffusion-7B Text2World 的位姿估计成功率为 62.6%,Video2World 为 68.4%,VideoLDM 基线仅为 4.4%。
结果说明 Cosmos 生成的视频具有更强的跨帧几何一致性,但这并不意味着模型内部一定建立了完整、显式的三维表示。
2. 物理动态评估
论文使用 Isaac Sim 和 PhysX 构建八类物理场景,包括:
- 自由落体;
- 斜坡运动;
- 物体堆叠;
- 多米诺骨牌;
- 跷跷板;
- 陀螺仪运动。
数据集共包含 800 段 1080p、100 帧的参考视频。
实验给模型提供前九帧,让其预测后续运动,再将生成视频中的物体位置与仿真器标准结果进行 IoU 比较。
7B 和 14B 扩散 Video2World 的平均 IoU 分别约为 0.592 和 0.598。
这表明模型已经学习到部分刚体运动规律,但距离精确模拟物理过程仍有明显差距。
八、安全机制
Cosmos 的 Guardrail 主要处理内容安全和隐私风险,而不是直接验证生成内容是否严格符合物理规律。
输入端使用:
- 关键词规则;
- Aegis;
- LlamaGuard。
输出端使用:
- 基于 SigLIP 特征的视频安全分类器;
- 逐帧内容过滤;
- RetinaFace 人脸检测与模糊处理。
客体永久性、几何一致性和动力学准确性属于模型能力评估问题,并不是 Guardrail 系统的主要职责。
九、局限性
Cosmos 仍存在三项关键限制。
第一,视觉合理不等于物理精确。模型可以生成看起来可信的视频,但不一定严格满足质量、摩擦、动量和接触约束。
第二,长时间预测容易积累误差。随着滚动生成持续进行,可能出现物体漂移、形状变化、突然消失或场景结构崩塌。
第三,论文尚未充分证明世界模型能够稳定提升真实机器人或自动驾驶系统的闭环性能。
论文展示了视频预测、相机控制、机器人动作条件生成和自动驾驶多视角生成,但没有系统验证:
- 使用 WFM 生成的数据能否提高真实机器人任务成功率;
- 世界模型预测能否稳定改善策略训练;
- 模型能否安全参与实时闭环控制;
- 在极端长尾场景中能否优于传统仿真方法。
因此,Cosmos 当前更接近一个高质量、可控的视觉动态预测平台,而不是完整的物理仿真器或已经成熟的机器人控制系统。
十、总结
Cosmos 的核心价值在于建立了一套世界基础模型的工业化开发范式。
它将大规模视频整理、因果视频 Tokenizer、扩散与自回归世界模型、领域后训练以及安全过滤统一在同一个平台中,使开发者能够在通用世界先验之上构建面向驾驶、机器人操作和工业场景的专用模型。
其中:
- 扩散模型侧重生成质量和空间一致性;
- 自回归模型侧重序列预测和推理效率;
- 连续 Token 适配扩散模型;
- 离散 Token 适配自回归模型;
- 后训练负责连接具体动作、传感器和应用领域;
- 传统物理仿真器继续承担精确建模和受控评估任务。
Cosmos 证明了世界模型可以作为 Physical AI 的通用预训练底座,但尚未证明其能够取代解析物理仿真,或稳定提高真实系统的闭环控制性能。这也是世界模型从“生成未来画面”走向“可靠指导物理行动”所必须完成的最后一步。