论文笔记 · 2026/07/24
: a VLA That Learns From Experience
: a VLA That Learns From Experience
https://arxiv.org/pdf/2511.14759
概括
论文提出 RECAP:通过价值函数评价机器人真实执行中的动作,再让 VLA 条件化地模仿“更有优势的动作”,使机器人不仅从人工演示中学习,还能利用自主成功、失败和人工纠正持续提升可靠性与执行速度
1. 解决了什么问题
传统 VLA 主要依靠模仿学习。它能让机器人基本“学会”任务,但难以达到实际部署需要的稳定性和速度:
- 运行时的小错误会逐步累积;
- 失败轨迹通常没有得到充分利用;
- 人类演示不一定是最快、最适合机器人的行为;
- PPO 等在线强化学习方法难以稳定、低成本地应用于大型 flow-matching VLA。
论文要解决的是:
如何让一个已有基础能力的通用机器人模型,从真实部署产生的经验和人工纠正中继续进步。
2. 方法设计:RECAP
RECAP 全称是:RL with Experience and Corrections via Advantage-conditioned Policies
其训练过程构成一个循环:
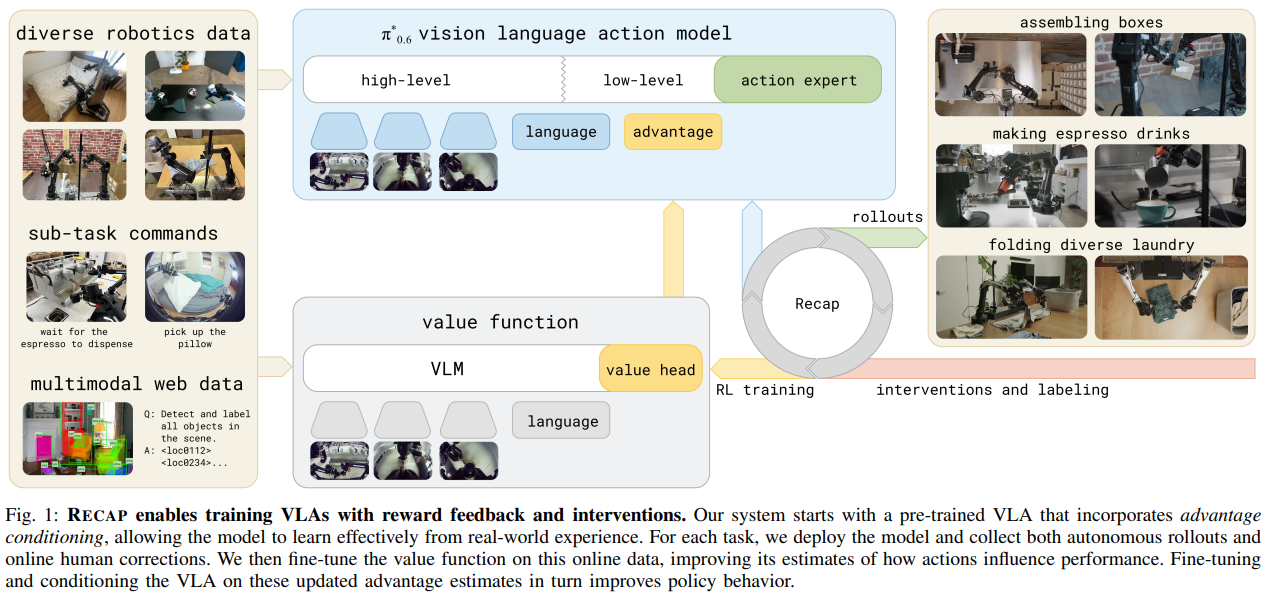
第一步:获得初始策略
先在多任务、多机器人数据上进行离线强化学习预训练,得到支持“优势条件”的通用模型 ;针对具体任务,再使用人工演示进行监督微调。
第二步:收集真实经验
将策略部署到机器人上,收集三类数据:
- 自主成功轨迹;
- 自主失败轨迹;
- 人类在机器人出错时提供的遥操作纠正。
第三步:判断哪些动作更好
训练一个价值函数,估计机器人当前离成功还有多远。比较动作执行前后的价值变化,得到动作的优势:
- 正优势:动作提高了成功概率或加快了任务进度;
- 负优势:动作导致错误、延迟或降低成功可能性。
优势随后被二值化为 positive 或 negative 标签。
第四步:训练优势条件策略
训练 VLA 同时学习: 即数据中的一般动作分布,
以及: 即具有正优势时的动作分布。
推理时输入 Advantage: positive,模型便倾向于选择价值函数认为更好的动作。人工纠正动作被直接视为正优势。更新后的模型再次部署,由此重复“执行—评价—训练”的循环。
3. 最终效果
论文在真实双臂机器人上测试了叠衣服、使用商业咖啡机制作 espresso,以及组装和贴标纸箱等长时序任务。
主要结果是:
- 在多样衣物折叠和制作 espresso 等困难任务上,加入真实机器人经验后,每小时成功完成数量提高到两倍以上;
- 整体失败率大约降低一半;
- 除最困难的多样衣物任务外,最终模型在主要任务上的成功率达到 90% 以上;
- 在针对性衣物实验中,仅利用自主经验、没有新增演示或人工干预,模型最终以 97% 的成功率消除了“衣领朝下”的特定失败模式;
- 相同数据条件下,RECAP 获得的任务吞吐量明显高于论文实现的 AWR 和 PPO 对照方法。
核心结论
这篇论文的关键贡献不是让机器人从零探索新任务,而是提供了一种实用方法,把已经“基本会做”的 VLA 进一步训练成:
其核心创新是把强化学习中的动作优势转化为 VLA 可以通过常规监督训练学习的输入条件,从而统一利用演示、自主成功、自主失败和人工纠正数据。当前系统仍需要人工标注成功与失败、提供部分干预并重置环境,因此尚未实现完全自主的持续学习。