论文笔记 · 2026/07/16
Diffusion Policy
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
#VLA#Diffusion
https://arxiv.org/abs/2303.04137
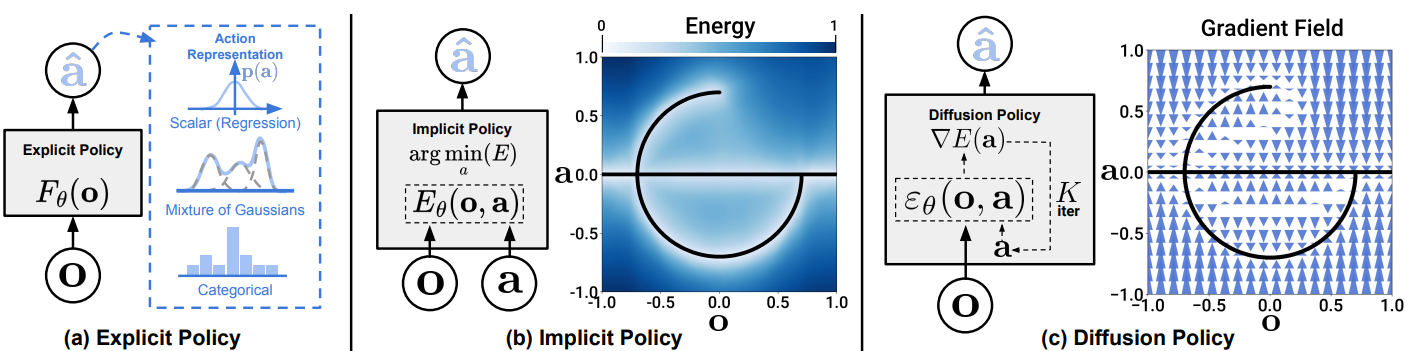
Diffusion Policy 是一种以当前观测为条件、从噪声中生成未来动作块,并通过滚动时域闭环执行的策略
传统行为直接回归动作:
Diffusion Policy 则学习条件动作分布:,其中 是一整段未来动作。
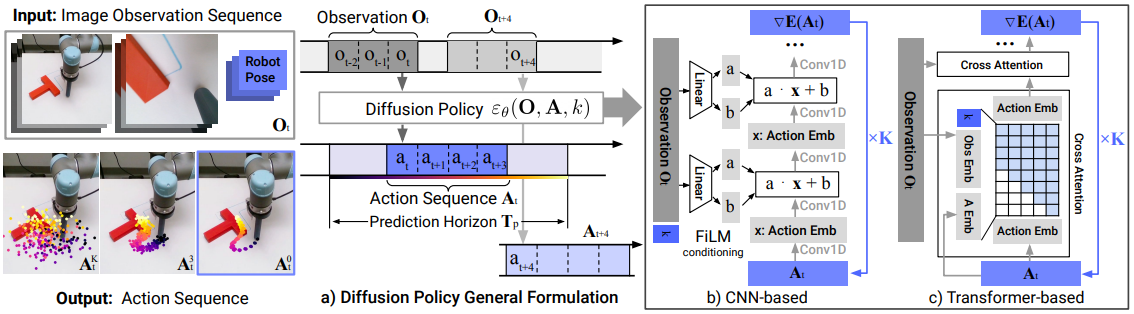
推理时从随机动作噪声出发,在当前观测 的约束下反复去噪,生成连贯动作序列
解决了同一观测可能对应多个合理动作,直接回归容易输出无效的“平均动作”
训练
数据提供:
其中 是专家的干净动作序列。随机选择扩散步 k,加入高斯噪声:
训练网络预测噪声:
损失为:
模型由此学会在观测 下,当前带噪动作序列应该如何被修正。
推理
先初始化纯噪声动作序列:
再多次调用同一个去噪网络:
最终得到未来 步动作,机器人只执行前 步,然后重新观察并生成新的动作序列
去噪网络
CNN-based
将动作序列视为多通道时间信号,用一维时间卷积处理;观测 和扩散步 k 通过 FiLM 注入各卷积层:
特点:稳定、适合平滑连续动作,但可能过度平滑快速变化的控制信号。
Transformer-based
将每个未来动作视为一个 token:
- causal self-attention:建模动作之间的时间依赖;
- cross-attention:让动作 token 查询观测特征;
- k embedding:表示当前噪声等级。
特点:更适合复杂时序和快速动作变化,但训练更敏感。两者只是噪声预测网络 的不同实现,扩散过程本身相同。
为什么合理
不同初始噪声可生成不同合理行为,而非平均行为